1. Що таке HTTP
Коли ми відкриваємо сайт, браузер має отримати його вміст із певного джерела. Коли натискаємо кнопку входу, надсилаємо форму або завантажуємо файл, браузер повинен передати відповідну інформацію серверу.
Для організації такого обміну використовується HTTP (Hypertext Transfer Protocol) — протокол передавання гіпертексту.
Протокол — це набір правил, за якими різні пристрої та програми взаємодіють між собою. Він визначає, як саме потрібно формувати повідомлення, які дані можна передавати та як інша сторона має відповідати.
HTTP є одним із фундаментальних протоколів Всесвітньої павутини (World Wide Web).
Наприклад, коли ми відкриваємо сторінку інтернет-магазину:
Браузер формує HTTP-запит із проханням отримати потрібну сторінку.
Запит надходить на сервер.
Сервер обробляє його та визначає, яку інформацію потрібно повернути.
Сервер формує HTTP-відповідь.
Браузер отримує відповідь і відображає сторінку.
Цей процес може повторюватися десятки або сотні разів під час одного відвідування сайту: окремо можуть завантажуватися HTML-документ, таблиці стилів CSS, JavaScript-файли, зображення, шрифти та інші ресурси.
Важливо розуміти: HTTP не є мовою програмування і не визначає, як виглядатиме вебсторінка. Він забезпечує правила обміну повідомленнями між клієнтом і сервером.
2. Клієнт, сервер і HTTP
У попередніх статтях ми вже познайомилися з поняттями клієнта та сервера. Тепер розглянемо їхню взаємодію детальніше.
Клієнт — це програма або пристрій, який ініціює запит до сервера. Найчастіше в контексті вебсайтів клієнтом виступає браузер.
Сервер — це комп'ютер або програмне забезпечення, яке приймає запити, обробляє їх і повертає відповіді.
Клієнтом може бути не лише браузер. Наприклад:
мобільний застосунок;
програма на комп'ютері;
інший сервер;
автоматизована система;
спеціальна програма для тестування API.
Уявімо інтернет-магазин.
Користувач відкриває сторінку товару. Браузер надсилає запит на сервер магазину. Сервер знаходить інформацію про товар і повертає її браузеру.
Потім користувач натискає кнопку «Додати до кошика». Браузер надсилає інший запит, але тепер його мета — не просто отримати інформацію, а передати серверу дані про дію користувача.
Отже, HTTP використовується як для отримання інформації, так і для передавання даних на сервер.
3. Як виглядає HTTP-запит
HTTP запит — це повідомлення, яке клієнт надсилає серверу.
У ньому зазначається, що саме потрібно зробити, до якого ресурсу звертається клієнт і яка додаткова інформація може знадобитися серверу.
Розглянемо спрощений приклад:
GET /products/15 HTTP/1.1Host: example.com
Accept: application/json
На перший погляд це просто кілька рядків тексту. Але кожен із них має своє призначення.
3.1. Метод запиту
GET
Метод повідомляє серверу, яку операцію хоче виконати клієнт.
У цьому прикладі використовується GET — запит на отримання інформації.
3.2. Шлях до ресурсу
/products/15Це шлях до ресурсу, з яким хоче взаємодіяти клієнт.
У нашому прикладі йдеться про товар із номером 15.
Шлях не обов'язково відповідає реальному розташуванню файлу на диску сервера. Він може бути адресою певної функції вебзастосунку, яка отримує дані з бази даних або виконує іншу операцію.
3.3. Версія HTTP
HTTP/1.1Цей запис вказує версію протоколу, у форматі якої сформовано повідомлення.
Існують різні версії HTTP:
HTTP/1.1;
HTTP/2;
HTTP/3.
Ми ще розглянемо їхні відмінності, але зараз достатньо знати, що вони розвивають один протокол і зберігають його основні принципи: запити, відповіді, методи, заголовки та коди стану.
3.4. Заголовки (Headers)
Host: example.com
Accept: application/json
Заголовки передають додаткову інформацію про запит.
У наведеному прикладі:
Host вказує адресу вебсайту, до якого звертається клієнт.
Accept повідомляє серверу, який формат відповіді клієнт може прийняти. Тут зазначено JSON.
Існує багато заголовків, які використовуються для різних завдань.
Наприклад:
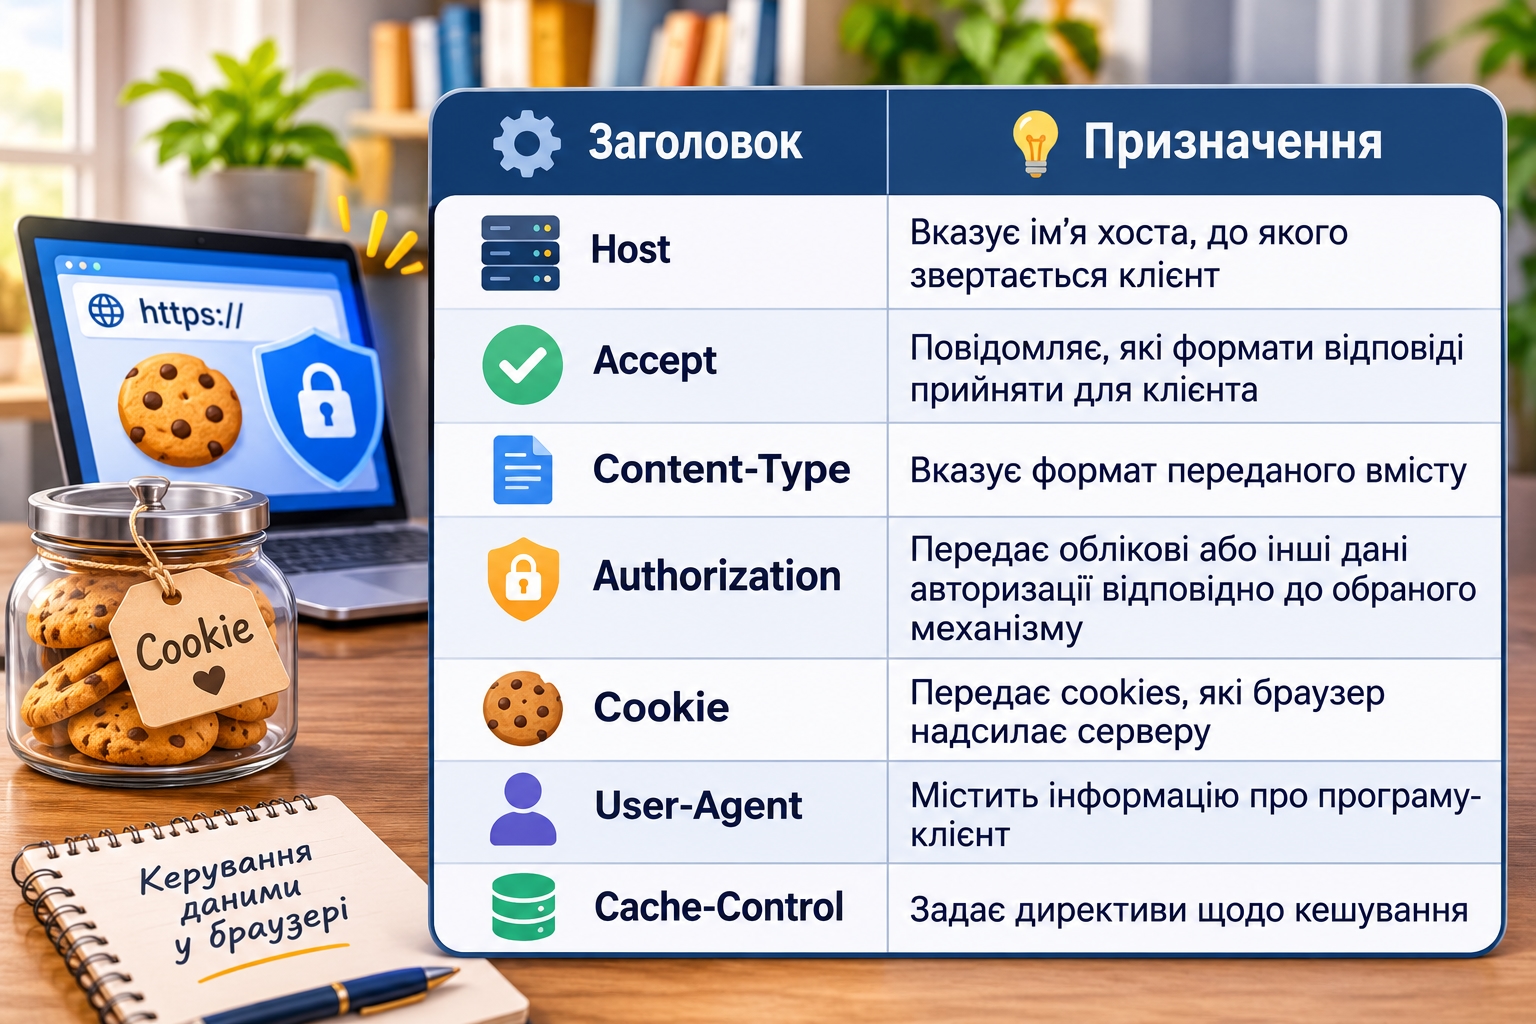
Не потрібно запам'ятовувати всі заголовки. Важливіше зрозуміти їхнє призначення: вони допомагають клієнту й серверу узгоджувати параметри обміну даними.
3.5. Тіло запиту (Body)
Деякі HTTP-запити містять тіло — частину повідомлення, у якій передаються дані.
Наприклад, користувач заповнив форму реєстрації. Браузер має передати серверу ім'я, електронну пошту та пароль.
Спрощений приклад:
POST /users HTTP/1.1

Host: example.com

Content-Type: application/json


{

  "name": "Dmytro",

  "email": "dmytro@example.com"

}
Тут:
POST — метод запиту;
/users — адреса ресурсу;
Content-Type: application/json — повідомляє, що тіло запиту містить JSON;
після порожнього рядка розташоване тіло запиту з даними користувача.
Зверни увагу: тіло запиту не обов'язково має бути у форматі JSON. Воно може містити звичайний текст, дані форми, зображення, файли та інший вміст.
Також не кожен HTTP-запит повинен мати тіло. Наприклад, звичайний GET-запит для отримання сторінки зазвичай його не містить.
4. Як виглядає HTTP-відповідь
Після отримання запиту сервер формує відповідь.
Відповідь повідомляє клієнту, чим завершилася операція, і за потреби повертає запитаний вміст.
Розглянемо приклад:
HTTP/1.1 200 OK

Content-Type: application/json


{

  "id": 15,

  "name": "Wireless Mouse",

  "price": 850

}
Розберемо його складові.
4.1. Статусний рядок
HTTP/1.1 200 OK
Він містить:
версію HTTP;
числовий код стану;
короткий текстовий опис результату.
У нашому прикладі код 200 означає, що запит успішно виконано.
Текст OK — короткий опис цього коду.
Головним для програмної обробки є саме числовий код. Текстовий опис не є основним джерелом інформації про результат.
4.2. Заголовки відповіді
Content-Type: application/jsonЦей заголовок повідомляє клієнту, у якому форматі сервер повернув дані.
У нашому випадку це JSON.
Інші приклади:
text/html — HTML-документ;
text/css — CSS-файл;
text/javascript — JavaScript;
image/png — зображення PNG;
application/pdf — PDF-документ.
4.3. Тіло відповіді
{

  "id": 15,

  "name": "Wireless Mouse",

  "price": 850

}
Це дані, які сервер повертає клієнту.
Браузер або інша програма може використати їх для подальшої роботи.
Наприклад, вебсторінка може отримати інформацію про товар і відобразити її користувачу.
Важливо: HTTP-відповідь не завжди повинна містити тіло.
Наприклад, відповідь зі статусом 204 No Content означає, що запит виконано успішно, але повертати вміст у тілі відповіді сервер не повинен.
5. Основні HTTP-методи
HTTP-методи визначають призначення запиту.
Це один із найважливіших елементів протоколу, оскільки одна й та сама адреса може використовуватися для різних операцій.
Наприклад, адреса:
https://example.com/users/15Може використовуватися для отримання інформації про користувача, її оновлення або видалення. Конкретну операцію визначає метод запиту та правила, налаштовані на сервері.
Розглянемо найпоширеніші методи.
5.1. GET — отримання інформації
GET використовується для отримання представлення певного ресурсу.
Наприклад:
GET /products HTTP/1.1

Host: example.com
Сервер може повернути список товарів.
Інший приклад:
GET /products/15 HTTP/1.1

Host: example.com
Тепер клієнт запитує інформацію про конкретний товар.
GET призначений для отримання даних, а не для зміни стану сервера.
Це означає, що відкриття сторінки товару не повинно автоматично створювати замовлення, видаляти товар або змінювати його ціну.
5.2. POST — передавання даних
POST використовується для передавання даних серверу. Часто така операція створює новий ресурс або спричиняє інші зміни на сервері.
Наприклад, реєстрація нового користувача:
POST /users HTTP/1.1

Host: example.com

Content-Type: application/json


{

  "name": "Dmytro",

  "email": "dmytro@example.com"

}
Сервер отримує інформацію та може створити нового користувача.
Інші приклади використання POST:
надсилання форми;
створення замовлення;
оформлення покупки;
відправлення повідомлення;
завантаження файлу.
5.3. PUT — заміна ресурсу
PUT зазвичай використовується для створення або повної заміни представлення ресурсу за вказаною адресою.
Наприклад:
PUT /users/15 HTTP/1.1

Host: example.com

Content-Type: application/json


{

  "name": "Dmytro",

  "email": "new-email@example.com"

}
Цей запит передає серверу нове представлення ресурсу користувача з ідентифікатором 15.
Важливо: PUT не слід плутати з частковим оновленням. Його стандартне призначення — заміна представлення ресурсу.
5.4. PATCH — часткове оновлення
PATCH використовується для внесення часткових змін до ресурсу.
Наприклад, потрібно змінити лише електронну пошту користувача:
PATCH /users/15 HTTP/1.1

Host: example.com

Content-Type: application/json


{

  "email": "new-email@example.com"

}
На відміну від типового використання PUT, тут передається лише інформація про зміну.
Конкретний формат таких змін залежить від правил API, яке обробляє запит.
5.5. DELETE — видалення ресурсу
DELETE використовується для видалення зазначеного ресурсу.
Наприклад:
DELETE /users/15 HTTP/1.1

Host: example.com
Сервер отримує запит на видалення користувача з ідентифікатором 15.
Фактичний результат залежить від реалізації сервера, прав доступу та наявності ресурсу.
5.6. Інші методи
Окрім основних, існують і додаткові методи:
HEAD — отримання заголовків відповіді без її тіла;
OPTIONS — отримання інформації про доступні параметри взаємодії з ресурсом;
CONNECT — встановлення тунелю до сервера, часто через проксі;
TRACE — діагностичний метод для перевірки шляху проходження повідомлення.
Для початкового знайомства з HTTP достатньо добре розуміти GET, POST, PUT, PATCH і DELETE.
5.7. Порівняння основних методів
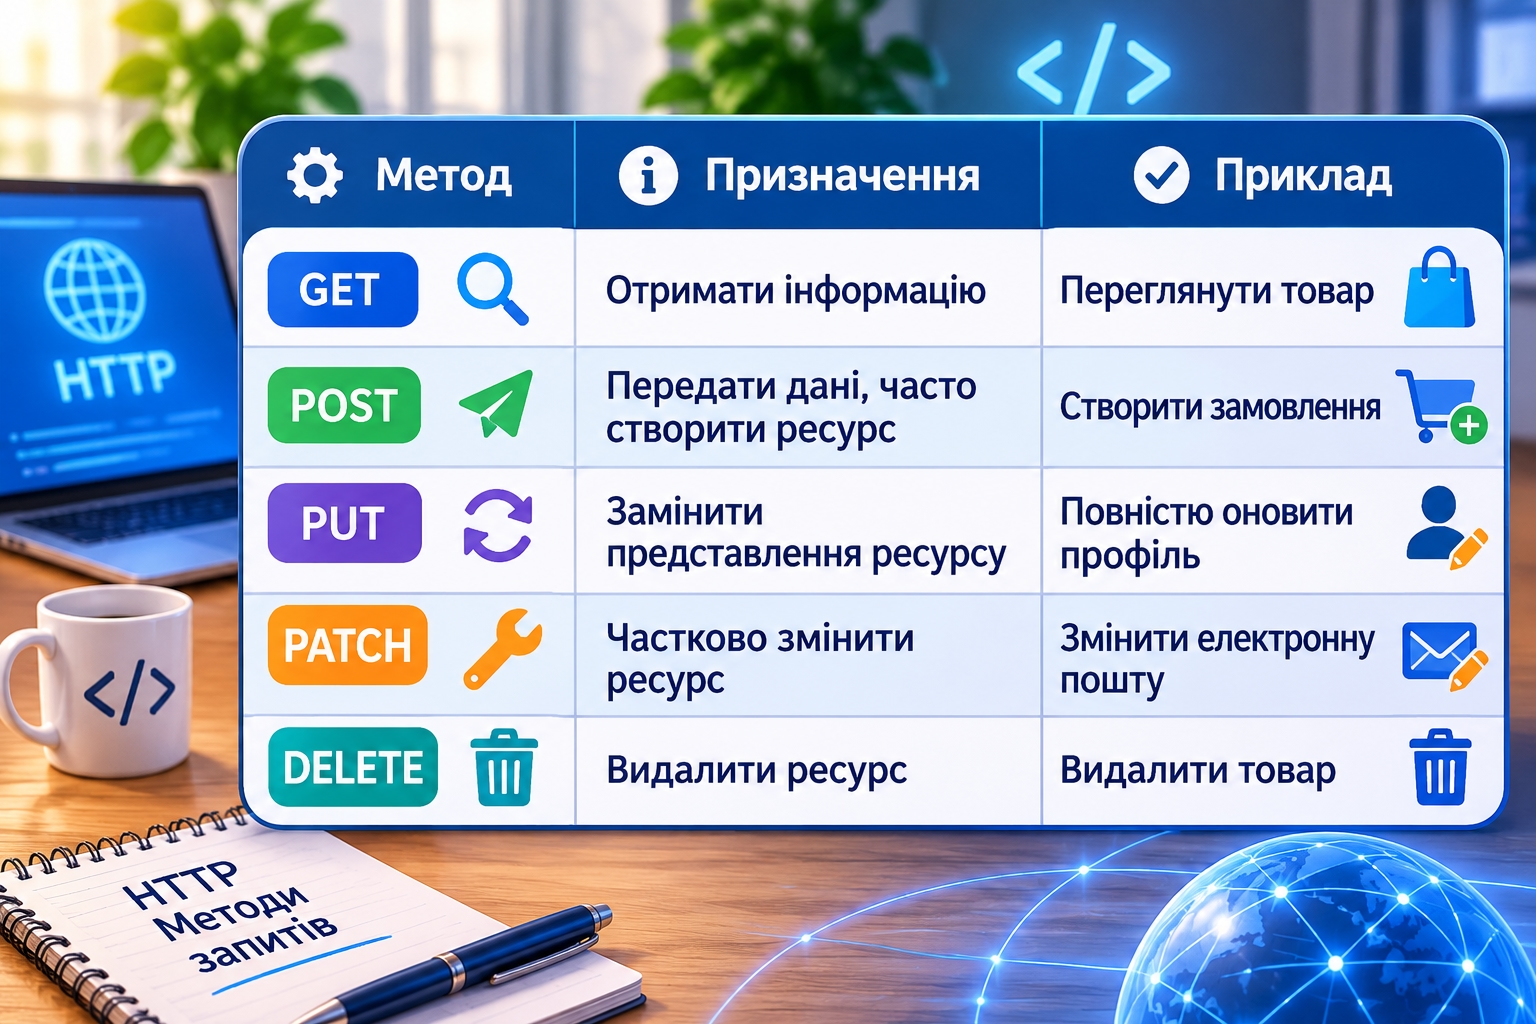
5.8. Безпечні та ідемпотентні методи
У HTTP існують два важливі поняття: безпечність методу та ідемпотентність.
Безпечний метод (Safe Method) — це метод, який за своїм призначенням не повинен змінювати стан сервера.
Наприклад, GET використовується для отримання інформації. Користувач може багато разів відкрити ту саму сторінку, не очікуючи, що кожне відкриття змінюватиме дані на сервері.
Ідемпотентний метод (Idempotent Method) — це метод, для якого повторення однакового запиту має той самий запланований ефект на сервері, що й одноразове виконання.
Наприклад, якщо ми надсилаємо DELETE-запит на видалення одного ресурсу, повторне надсилання такого самого запиту не повинно спричиняти додаткових змін після першого видалення.
При цьому відповіді сервера можуть відрізнятися. Перший запит може повернути 200 OK, а наступний — 404 Not Found, оскільки ресурс уже видалений.
Для порівняння:
GET — безпечний та ідемпотентний;
PUT — не є безпечним, але є ідемпотентним;
DELETE — не є безпечним, але є ідемпотентним;
POST — не є безпечним і не гарантує ідемпотентності;
PATCH — не є безпечним і не гарантує ідемпотентності.
Навіщо це потрібно?
Уявімо, що інтернет-магазин отримав запит на створення замовлення, але через проблеми з мережею клієнт не отримав відповідь.
Клієнт не знає, чи було створено замовлення. Якщо він просто повторить POST-запит, може випадково створити друге замовлення.
Тому в реальних системах використовують додаткові механізми захисту від повторного виконання операцій, наприклад ключі ідемпотентності, якщо їх підтримує API.
6. Коди стану HTTP
Після обробки запиту сервер повертає код стану.
Він допомагає зрозуміти, чи вдалося виконати операцію, чи потрібно перейти за іншою адресою, чи виникла помилка.
Коди стану поділяються на п'ять груп.
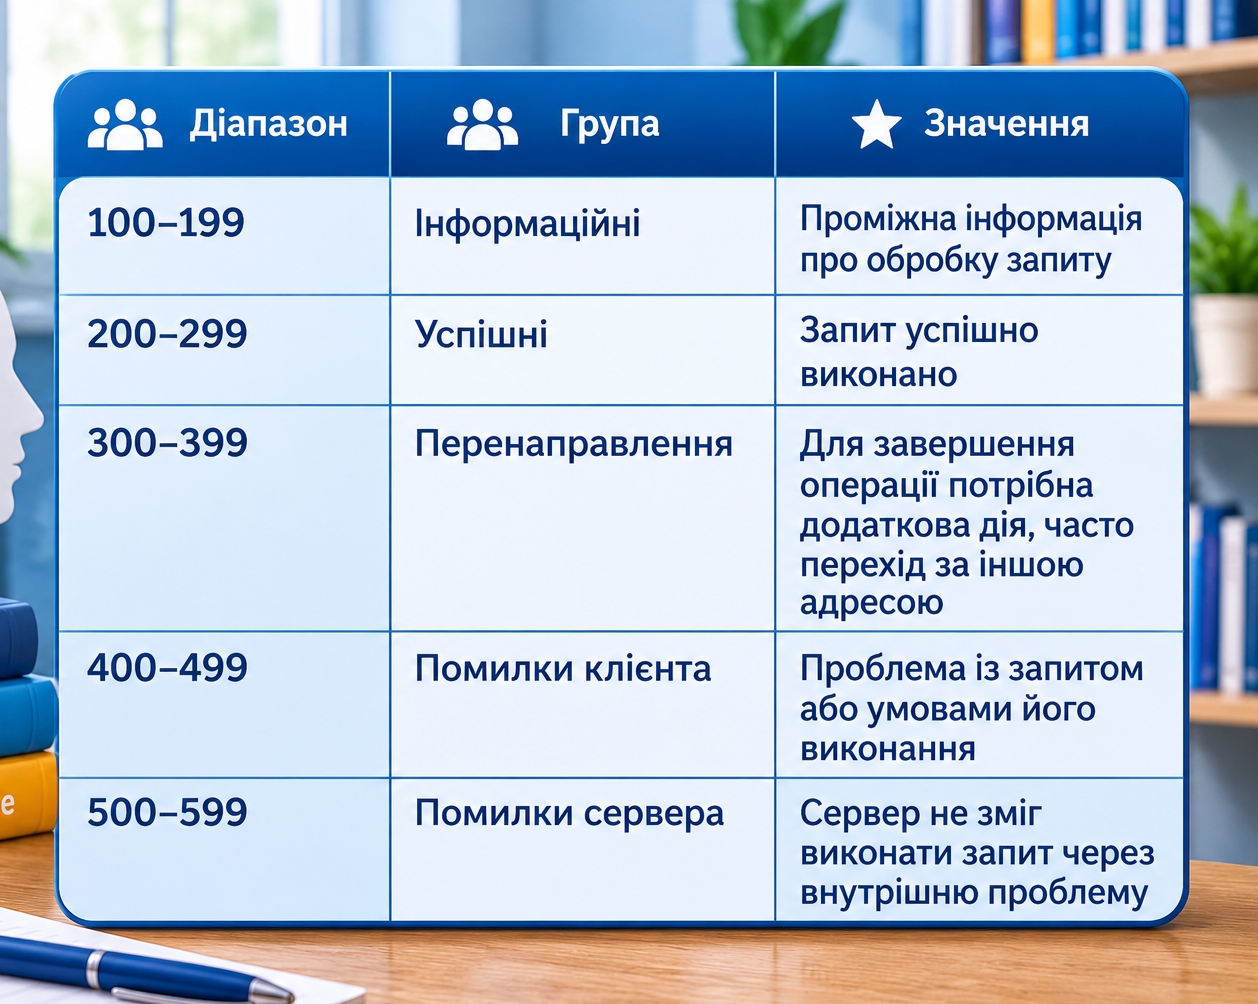
Розглянемо найпоширеніші коди.
6.1. Успішні відповіді — 2xx
200 OK
Запит успішно виконано.
Наприклад, сервер отримав запит на перегляд товару та повернув його інформацію.
201 Created
Запит успішно виконано, у результаті створено новий ресурс.
Наприклад, користувач зареєструвався, і сервер створив новий обліковий запис.
204 No Content
Запит успішно виконано, але відповідь не містить тіла.
Наприклад, сервер успішно обробив запит на видалення ресурсу й не повернув додаткових даних.
6.2. Перенаправлення — 3xx
301 Moved Permanently
Ресурс постійно переміщений на іншу адресу.
Наприклад, сайт змінив адресу сторінки, і сервер повідомляє браузеру, що потрібно використовувати нову адресу.
302 Found
Сервер повідомляє про тимчасове перенаправлення на іншу адресу.
Наприклад, користувача тимчасово направляють на сторінку входу.
304 Not Modified
Ресурс не змінився порівняно з версією, яку клієнт уже має в кеші. Браузер може використати збережену копію замість повторного завантаження всього вмісту.
Кешування розглянемо окремо трохи нижче.
6.3. Помилки клієнта — 4xx
400 Bad Request
Сервер не може обробити запит через помилку в його структурі або вмісті.
Наприклад, клієнт передав дані в неправильному форматі.
401 Unauthorized
Запит не має належної автентифікації. Зазвичай користувачу потрібно увійти в систему або надати відповідні облікові дані.
Попри назву, цей код пов'язаний саме з відсутністю або неприйнятністю автентифікаційних даних.
403 Forbidden
Сервер зрозумів запит, але відмовляє у виконанні через відсутність необхідних прав або з інших причин доступу.
Наприклад, користувач увійшов у систему, але не має дозволу переглядати адміністративну сторінку.
404 Not Found
Запитаний ресурс не знайдено.
Наприклад, сторінка видалена або адреса введена неправильно.
429 Too Many Requests
Клієнт надіслав занадто багато запитів за певний проміжок часу.
Цей код часто використовується для обмеження частоти звернень до сервера.
6.4. Помилки сервера — 5xx
500 Internal Server Error
На сервері сталася внутрішня помилка, через яку він не зміг виконати запит.
502 Bad Gateway
Сервер, який працює як шлюз або проксі, отримав некоректну відповідь від іншого сервера, до якого звертався.
503 Service Unavailable
Сервер тимчасово не може обробляти запити.
Причиною може бути технічне обслуговування, перевантаження або тимчасова недоступність необхідних компонентів.
504 Gateway Timeout
Сервер-шлюз або проксі не дочекався вчасної відповіді від іншого сервера.
6.5. Як запам'ятати групи кодів
Найпростіше запам'ятати першу цифру:
2xx — усе успішно;
3xx — потрібне перенаправлення;
4xx — проблема із запитом або доступом;
5xx — проблема на боці сервера.
Не кожен код усередині групи означає саме те, що можна припустити за назвою групи. Тому під час розробки або пошуку помилки важливо перевіряти конкретний код.
7. URL: як HTTP-запит знаходить потрібний ресурс
У першій статті ми вже розглядали доменні імена, DNS та IP-адреси. Тепер подивимося, як URL пов'язаний із HTTP-запитом.
URL (Uniform Resource Locator) — це адреса ресурсу в мережі.
Наприклад:
https://example.com/products/15?color=black&size=large
Розглянемо його складові:
https://
Схема — вказує протокол або спосіб доступу до ресурсу.
Доменне ім'я — вказує на хост, до якого звертається клієнт.
/products/15
Шлях — визначає ресурс або маршрут, до якого звертається клієнт.
?color=black&size=largeПараметри запиту — додаткова інформація, яка передається в адресі.
У нашому прикладі параметри можуть означати, що користувач шукає чорний товар великого розміру.
Параметри розділяються символом &, а після ? починається їхній перелік.
Важливо: параметри URL не є захищеним місцем для передавання секретної інформації. Адреси можуть зберігатися в історії браузера, потрапляти до журналів серверів і передаватися в інших контекстах.
Тому паролі та інші конфіденційні дані не слід передавати в URL.
7.1. Чи є URL і HTTP одним і тим самим?
Ні.
URL — це адреса ресурсу.
HTTP — протокол, за допомогою якого клієнт і сервер можуть обмінюватися повідомленнями щодо цього ресурсу.
Для порівняння:
URL відповідає на запитання: «Куди звертаємося?»
HTTP-метод відповідає на запитання: «Яку операцію хочемо виконати?»
HTTP-заголовки передають додаткові параметри.
Тіло запиту може містити дані, які передає клієнт.
Код стану відповіді повідомляє про результат.
8. HTTP є протоколом без збереження стану
Одна з важливих властивостей HTTP — stateless, тобто протокол без збереження стану між окремими запитами.
Це означає, що сам по собі HTTP не зобов'язаний пам'ятати, що відбувалося під час попереднього запиту.
Уявімо ситуацію:
Користувач відкрив сторінку інтернет-магазину.
Додав товар до кошика.
Перейшов на іншу сторінку.
Відкрив сторінку оформлення замовлення.
Для користувача це одна безперервна взаємодія із сайтом. Але на рівні HTTP це можуть бути окремі запити.
Якщо кожен запит розглядати незалежно, серверу потрібно якимось чином зрозуміти, що всі вони належать одному користувачу та його кошику.
Для цього використовуються додаткові механізми.
Один із найпоширеніших — cookies.
Cookie — це невеликий фрагмент даних, який сайт може зберігати в браузері. За відповідних налаштувань браузер надсилає його серверу під час наступних запитів.
Наприклад, сервер може створити ідентифікатор сесії та передати його браузеру через заголовок Set-Cookie.
Спрощений приклад відповіді:
HTTP/1.1 200 OK

Set-Cookie: session_id=abc123; HttpOnly; Secure; SameSite=Lax
Після цього браузер може надсилати відповідний cookie у наступних запитах до цього сайту.
Спрощений приклад:
GET /account HTTP/1.1

Host: example.com

Cookie: session_id=abc123
Сервер отримує ідентифікатор і може пов'язати запит із відповідною сесією.
Це один із механізмів, завдяки якому сайт може підтримувати авторизацію користувача, зберігати кошик або інші налаштування.
Важливе уточнення: HTTP залишається протоколом без збереження стану, навіть якщо застосунок використовує cookies та сесії. Стан реалізується додатковими механізмами на рівні вебзастосунку.
Детальніше розглянемо це в дев'ятій статті.
9. Кешування HTTP
Уявімо, що ти відкриваєш один і той самий сайт десять разів за день.
Чи потрібно браузеру щоразу завантажувати всі зображення, стилі, шрифти та інші файли з сервера?
Не обов'язково.
Для зменшення кількості запитів і прискорення завантаження сайтів використовується кешування (Caching).
Кеш — це тимчасове зберігання даних, які можуть знадобитися повторно.
Браузер може зберігати:
зображення;
CSS-файли;
JavaScript-файли;
інші ресурси;
певні відповіді сервера, якщо це дозволяють правила кешування.
Наприклад, під час першого відвідування сайту браузер завантажує логотип і зберігає його в кеші.
Під час наступного відвідування браузер може використати збережену копію, не завантажуючи файл повністю повторно.
9.1. Заголовки кешування
Для керування кешуванням використовуються HTTP-заголовки.
Наприклад:
Cache-Control: max-age=3600Це вказує, що відповідь може вважатися свіжою протягом 3600 секунд, тобто однієї години, відповідно до правил цього заголовка.
Інший приклад:
Cache-Control: no-storeЦя директива забороняє зберігати відповідь у кеші.
Також існують заголовки ETag і Last-Modified, які допомагають перевіряти, чи змінився ресурс після попереднього завантаження.
9.2. Як працює перевірка кешу
Уявімо, що браузер уже має збережену копію зображення.
Він може звернутися до сервера та запитати, чи змінилося воно.
Наприклад:
GET /images/logo.png HTTP/1.1

Host: example.com

If-None-Match: "abc123"
Якщо ресурс не змінився, сервер може повернути:
HTTP/1.1 304 Not ModifiedЦе означає, що браузер може використати свою збережену копію.
Якщо ресурс змінився, сервер може повернути нову версію з кодом 200 OK та відповідним вмістом.
Кешування допомагає:
швидше відкривати сторінки;
зменшувати обсяг переданих даних;
знижувати навантаження на сервер;
покращувати загальну продуктивність вебсайтів.
Водночас неправильні налаштування кешування можуть призвести до того, що користувач бачитиме застарілу версію сторінки або файлу.
10. Як HTTP пов'язаний із HTML, CSS і JavaScript
Ми вже розглядали три основні технології створення вебсторінок:
HTML — структура;
CSS — оформлення;
JavaScript — поведінка та інтерактивність.
Тепер додамо до них HTTP.
Уявімо, що користувач відкриває сторінку сайту.
Браузер надсилає HTTP-запит на отримання HTML-документа.
Сервер повертає HTML.
Браузер починає аналізувати документ і знаходить посилання на CSS-файл:
<link rel="stylesheet" href="style.css">Потім браузер надсилає окремий HTTP-запит, щоб отримати таблицю стилів.
Так само він знаходить JavaScript-файл:
<script src="script.js" defer></script>І надсилає ще один запит для його завантаження.
Якщо в HTML є зображення:
<img src="images/photo.jpg" alt="Фото товару">Браузер може надіслати додатковий запит за цим зображенням.
Таким чином, одна вебсторінка може складатися з багатьох ресурсів, які браузер отримує за допомогою HTTP.
10.1. Як JavaScript використовує HTTP
JavaScript може не лише реагувати на натискання кнопок і змінювати вміст сторінки.
Він також може надсилати HTTP-запити до сервера.
Для цього в сучасних браузерах використовується Fetch API.
Наприклад:
fetch("https://example.com/products")

  .then(response => response.json())

  .then(data => {

    console.log(data);

  })

  .catch(error => {

    console.error("Помилка:", error);

  });
Що відбувається в цьому прикладі?
fetch() надсилає запит за вказаною адресою. Якщо метод не задано окремо, використовується GET.
Сервер повертає HTTP-відповідь.
response.json() читає тіло відповіді та перетворює JSON на об'єкт JavaScript.
console.log(data) виводить отримані дані в консоль.
catch() обробляє помилки, пов'язані з виконанням запиту.
Важливий момент: Fetch API не вважає HTTP-статуси на кшталт 404 або 500 автоматично помилкою виконання промісу. Для перевірки результату потрібно окремо аналізувати response.ok або response.status.
Наприклад:
fetch("https://example.com/products")

  .then(response => {

    if (!response.ok) {

      throw new Error("HTTP-помилка: " + response.status);

    }


    return response.json();

  })

  .then(data => {

    console.log("Отримані товари:", data);

  })

  .catch(error => {

    console.error("Помилка:", error);

  });
Це вже приклад реальної взаємодії JavaScript із сервером.
Ми не будемо зараз заглиблюватися в API та програмування серверної частини. Ці теми розглянемо окремо у восьмій статті.
11. Як подивитися HTTP-запити у браузері
Тепер перейдемо до практики.
Не обов'язково бути програмістом, щоб побачити, як браузер взаємодіє із серверами. Для цього достатньо скористатися вбудованими інструментами розробника.
У браузерах Chrome, Edge та Firefox є інструменти Developer Tools.
11.1. Відкриття Developer Tools
У Google Chrome або Microsoft Edge:
Відкрий будь-який сайт.
Натисни клавішу F12.
Перейди на вкладку Network.
Онови сторінку клавішею F5.
У вкладці Network з'явиться список мережевих запитів.
Кожен рядок відповідає окремому запиту, який браузер виконав під час завантаження сторінки або її подальшої роботи.
Там можна побачити:
адресу ресурсу;
метод запиту;
код стану;
тип ресурсу;
обсяг переданих даних;
час виконання запиту.
11.2. Як переглянути конкретний запит
Натисни на будь-який рядок у списку.
Залежно від браузера та вибраного запиту ти побачиш кілька розділів.
Headers
Тут можна переглянути:
Request URL — адресу запиту;
Request Method — метод;
Status Code — код стану;
Request Headers — заголовки запиту;
Response Headers — заголовки відповіді.
Payload
Тут відображаються дані, які клієнт передав серверу в тілі запиту, якщо вони є.
Preview
Тут можна побачити зручне представлення отриманої відповіді, якщо браузер може його сформувати.
Response
Тут відображається тіло відповіді сервера.
Timing
Тут показується розподіл часу, який витратив запит на різні етапи виконання.
Назви та доступність вкладок можуть відрізнятися залежно від браузера й типу запиту.
11.3. Практичне завдання
Спробуй виконати невеликий експеримент.
Відкрий будь-який сайт.
Натисни F12.
Перейди у вкладку Network.
Онови сторінку.
Знайди запит, у якого метод GET.
Відкрий його.
Знайди Request URL, Status Code і Content-Type.
Переглянь вкладку Response.
Після цього спробуй відповісти на запитання:
Який ресурс запитував браузер?
Який метод використовувався?
Який код стану повернув сервер?
У якому форматі надійшла відповідь?
Що містило тіло відповіді?
Повтори експеримент на іншому сайті та порівняй результати.
Порада: якщо запитів дуже багато, скористайся фільтрами Fetch/XHR, Doc, JS, CSS та Img. Вони допоможуть відокремити запити за типами ресурсів.
12. HTTP і безпека: що потрібно знати зараз
HTTP визначає правила обміну даними, але сам по собі не забезпечує шифрування переданого вмісту.
Це означає, що звичайне HTTP-з'єднання не забезпечує конфіденційність даних під час передавання мережею.
Наприклад, якщо сайт використовує звичайний HTTP, передані дані можуть бути доступними для перегляду або зміни зловмисниками, які мають відповідні можливості перехоплення трафіку.
Саме тому для сучасних вебсайтів використовують HTTPS.
HTTPS — це HTTP, який працює із захистом за допомогою TLS (Transport Layer Security).
TLS забезпечує:
шифрування переданих даних;
перевірку автентичності сервера;
захист цілісності повідомлень під час передавання.
Наприклад, якщо ти вводиш пароль на сайті, який використовує HTTPS, TLS допомагає захистити його під час передавання між браузером і сервером.
Водночас важливо пам'ятати: HTTPS не гарантує, що сам сайт є чесним або безпечним у всіх інших аспектах. Він захищає з'єднання, але не може автоматично зробити надійним власника сайту, його програмний код чи обробку даних.
У шостій статті ми детально розглянемо, як працюють HTTPS, TLS, сертифікати та захищені з'єднання.
13. Підсумок: що ми дізналися
HTTP — це протокол, який забезпечує обмін повідомленнями між клієнтом і сервером.
Під час роботи із сайтом браузер надсилає HTTP-запити, а сервер повертає HTTP-відповіді.
Основні складові запиту:
метод;
шлях до ресурсу;
версія протоколу;
заголовки;
необов'язкове тіло запиту.
Основні складові відповіді:
версія протоколу;
код стану;
заголовки;
необов'язкове тіло відповіді.
Ми розглянули основні HTTP-методи:
GET — отримання даних;
POST — передавання даних;
PUT — заміна ресурсу;
PATCH — часткове оновлення;
DELETE — видалення ресурсу.
Також познайомилися з групами кодів стану:
2xx — успішне виконання;
3xx — перенаправлення;
4xx — помилки клієнта;
5xx — помилки сервера.
Окремо розглянули заголовки, cookies, кешування, URL та інструменти браузера для перегляду мережевих запитів.
Найважливіше — зрозуміти загальний принцип:
Браузер формує запит → сервер його обробляє → сервер повертає відповідь → браузер використовує отримані дані.
Саме на цьому принципі побудована значна частина взаємодії у Всесвітній павутині.
14. Практичні запитання для самоперевірки
Що таке HTTP і для чого він використовується?
Чим відрізняється клієнт від сервера?
Яку інформацію містить HTTP-запит?
Для чого потрібні HTTP-заголовки?
Чим відрізняються GET і POST?
У чому різниця між PUT і PATCH?
Що означає код 200 OK?
Чим відрізняються 401 Unauthorized і 403 Forbidden?
Що означає код 404 Not Found?
Чим відрізняються помилки 4xx від помилок 5xx?
Що таке ідемпотентність HTTP-методу?
Чому HTTP називають протоколом без збереження стану?
Для чого використовуються cookies?
Що таке кешування і навіщо воно потрібне?
Чим відрізняються URL і HTTP?
Як JavaScript може взаємодіяти із сервером?
Де у браузері можна переглянути HTTP-запити?
Чому HTTPS безпечніший за звичайний HTTP?
15. Словник основних термінів
HTTP (Hypertext Transfer Protocol) — протокол обміну даними між клієнтом і сервером у вебсередовищі.
Client (Клієнт) — програма або пристрій, який ініціює запит до сервера.
Server (Сервер) — система, яка приймає та обробляє запити й повертає відповіді.
Request (Запит) — повідомлення, яке клієнт надсилає серверу.
Response (Відповідь) — повідомлення, яке сервер повертає клієнту.
HTTP Method (HTTP-метод) — визначає призначення запиту: отримання, передавання, оновлення або видалення даних.
Header (Заголовок) — додаткова інформація, що передається разом із HTTP-повідомленням.
Body (Тіло повідомлення) — частина HTTP-повідомлення, яка може містити дані.
Status Code (Код стану) — числовий показник результату обробки запиту.
URL (Uniform Resource Locator) — адреса ресурсу в мережі.
Cookie — невеликий фрагмент даних, який сайт може зберігати в браузері та використовувати під час наступних запитів.
Session (Сесія) — механізм, який дає змогу пов'язувати кілька запитів із певним користувачем або сеансом взаємодії.
Caching (Кешування) — тимчасове зберігання даних для швидшого повторного доступу.
Fetch API — інструмент JavaScript для виконання мережевих запитів.
API (Application Programming Interface) — інтерфейс, через який одна програма може взаємодіяти з іншою.
TLS (Transport Layer Security) — протокол захисту передавання даних, який використовується, зокрема, у HTTPS.
16. Джерела та матеріали для подальшого вивчення
Матеріал статті підготовлено з опорою на документацію MDN Web Docs та стандарти HTTP.
MDN Web Docs — Overview of HTTP. Загальний принцип роботи HTTP, клієнт-серверна модель, запити та відповіді.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/OverviewMDN Web Docs — HTTP Messages. Структура HTTP-запитів і відповідей, заголовки та тіло повідомлень.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/MessagesMDN Web Docs — HTTP Request Methods. Докладний опис HTTP-методів, їхніх властивостей і призначення.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/MethodsMDN Web Docs — HTTP Response Status Codes. Довідник кодів стану HTTP.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/StatusMDN Web Docs — HTTP Headers. Довідник заголовків HTTP.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/HeadersMDN Web Docs — HTTP Caching. Принципи кешування HTTP-ресурсів.
https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/CachingRFC 9110 — HTTP Semantics. Офіційний стандарт, який визначає семантику HTTP: методи, статуси, заголовки та загальні правила взаємодії.
https://www.rfc-editor.org/rfc/rfc9110
Для початку рекомендую прочитати перші чотири джерела. Вони допоможуть закріпити основи HTTP, а решта стануть у пригоді під час практичного вивчення вебтехнологій.