Вступ. Від окремих технологій до єдиної системи
Ми вже розглянули дев'ять важливих складових сучасного вебу: HTML, CSS, JavaScript, HTTP, HTTPS, DNS, вебсервери, бази даних, API, cookies та сесії. Кожна з них виконує власну функцію, але жодна окремо не пояснює, як працює повноцінний вебсайт.
Щоб зрозуміти це, потрібно побачити загальну картину.
Уявімо звичайну ситуацію: людина відкриває інтернет-магазин, знаходить товар, додає його до кошика й оформлює замовлення.
З погляду користувача все відбувається майже миттєво: натиснув кнопку — і товар опинився в кошику. Але за цією простою дією стоїть взаємодія браузера, мережевих протоколів, вебсервера, серверної програми та бази даних.
Саме цей шлях ми й простежимо.
Мета статті — не повторити попередні матеріали, а з'єднати їх у цілісну модель. Після прочитання має стати зрозуміло, хто за що відповідає, як компоненти передають інформацію один одному та чому для роботи сучасного сайту потрібна ціла система технологій.
1. З чого складається сучасний вебсайт?
Перш ніж розглядати шлях запиту, потрібно визначити основні частини системи.
У спрощеному вигляді сучасний вебсайт складається з чотирьох взаємопов'язаних частин:
Клієнтська частина (Frontend) — усе, з чим безпосередньо взаємодіє користувач у браузері.
Серверна частина (Backend) — програма, яка обробляє запити, виконує логіку сайту та керує доступом до даних.
База даних (Database) — місце, де зберігається інформація.
Мережева та серверна інфраструктура — компоненти, завдяки яким сайт доступний через інтернет.
Розглянемо їх окремо.
1.1. Клієнтська частина — те, що бачить користувач
Клієнтська частина працює переважно у веббраузері. Вона відповідає за відображення сторінок, взаємодію з користувачем та передавання запитів до сервера.
Її основою є три технології:
HTML визначає структуру та зміст сторінки.
CSS відповідає за зовнішній вигляд і розташування елементів.
JavaScript забезпечує інтерактивність та дає змогу сторінці реагувати на дії користувача.
Наприклад, сторінка товару може містити його назву, фотографію, опис, ціну та кнопку «Додати до кошика».
HTML створює структуру цих елементів, CSS оформлює їх, а JavaScript обробляє натискання кнопки та запускає необхідну дію.
1.2. Серверна частина — логіка вебсайту
Frontend не повинен самостійно виконувати всі операції. Він відповідає за взаємодію з користувачем, але багато важливих рішень ухвалюються на сервері.
Серверна частина, або Backend, може:
перевіряти дані, які надійшли від користувача;
визначати, чи має користувач право виконати певну дію;
розраховувати вартість замовлення;
перевіряти наявність товару;
взаємодіяти з базою даних;
створювати замовлення та змінювати його статус;
повертати результат браузеру.
Наприклад, JavaScript може передати серверу інформацію про товар, який користувач хоче придбати. Але саме сервер повинен перевірити його актуальну ціну, наявність і можливість оформлення замовлення.
Це важливо: не можна довіряти лише даним, які надходять із браузера. Користувач може змінити їх через інструменти розробника або сформувати власний запит.
1.3. База даних — місце зберігання інформації
Інтернет-магазин повинен пам'ятати багато інформації:
перелік товарів;
ціни та залишки;
облікові записи користувачів;
адреси доставки;
кошики;
замовлення та їхні статуси.
Для цього використовують бази даних.
Backend звертається до бази даних, коли потрібно отримати, створити, змінити або видалити інформацію.
Наприклад, після оформлення замовлення сервер може зберегти в базі даних його номер, склад, загальну суму, покупця та дату створення.
1.4. Інфраструктура — де працює сайт
Щоб сайт був доступний через інтернет, його компоненти повинні десь працювати та бути підключеними до мережі.
Для цього використовують:
сервери або хмарні обчислювальні ресурси;
вебсерверне програмне забезпечення;
хостинг;
доменні імена;
DNS;
мережеве обладнання та проміжні сервіси.
У невеликому проєкті кілька компонентів можуть працювати на одному сервері. У великій системі їх можуть розміщувати на різних серверах, у хмарній інфраструктурі або в кількох датацентрах.
Отже, вебсайт — це не просто набір HTML-файлів.
Це система, у якій клієнтська частина, серверна логіка, база даних та інфраструктура виконують різні, але взаємозалежні функції.
2. Користувач вводить адресу: як браузер знаходить сайт
Почнемо наш наскрізний приклад.
Користувач хоче відкрити інтернет-магазин і вводить у браузері адресу:
https://shop.example.comЦе URL — адреса ресурсу в інтернеті. У нашому прикладі вона містить:
https — схему доступу, яка вказує на використання захищеного HTTP-з'єднання;
shop.example.com — доменне ім'я сайту.
Браузер повинен з'ясувати, до якого сервера потрібно звернутися. Але доменне ім'я саме по собі не є мережевою адресою сервера.
2.1. DNS перетворює домен на IP-адресу
Для пошуку мережевої адреси використовується
DNS — Domain Name System.
DNS можна уявити як розподілену систему довідників, яка допомагає знаходити IP-адреси за доменними іменами.
Коли браузеру потрібна адреса shop.example.com, система звертається до DNS-резолвера. Той може використати вже збережені результати або виконати пошук через DNS-сервери.
У результаті браузер отримує IP-адресу, наприклад:
203.0.113.10Це умовна адреса для демонстрації, а не реальна адреса нашого магазину.
Тепер браузер знає, куди направляти мережеве з'єднання.
Важливо: DNS не передає браузеру сам сайт, його HTML або зображення. Його завдання — допомогти знайти потрібну мережеву адресу.
2.2. Чому домен і IP — не одне й те саме?
Доменне ім'я зручне для людини: його легше запам'ятати та використовувати.
IP-адреса потрібна для мережевої взаємодії між пристроями.
Один сервер може обслуговувати кілька доменів, а один сайт може використовувати кілька серверів.
Тому зв'язок між доменом та IP-адресою не завжди є простим співвідношенням «один до одного».
Після того як адресу знайдено, можна переходити до встановлення з'єднання.
3. Встановлення з'єднання: TCP, TLS та HTTPS
Знаючи IP-адресу сервера, браузер повинен встановити з ним мережеве з'єднання.
У традиційній схемі HTTPS поверх TCP цей процес складається з двох важливих етапів.
3.1. TCP — встановлення надійного з'єднання
TCP (Transmission Control Protocol) — транспортний протокол, який забезпечує надійне передавання даних між пристроями.
Перед передаванням інформації TCP встановлює з'єднання за допомогою триетапного процесу, який називають TCP handshake:
Клієнт надсилає серверу запит на встановлення з'єднання.
Сервер підтверджує, що готовий до взаємодії.
Клієнт підтверджує отримання відповіді.
Після цього між сторонами встановлено TCP-з'єднання.
TCP допомагає забезпечити доставлення даних у правильному порядку, виявляти втрати або пошкодження сегментів та повторно передавати дані, доставлення яких не було підтверджено.
3.2. TLS — захист передавання інформації
Саме по собі TCP-з'єднання не шифрує дані. Якщо передавати інформацію через звичайний HTTP, її вміст може бути доступний для перегляду або зміни на шляху передавання.
Для захисту використовується TLS (Transport Layer Security).
Під час встановлення TLS-з'єднання браузер і сервер узгоджують параметри захисту, перевіряють автентичність сервера за допомогою цифрового сертифіката та встановлюють ключі для шифрування подальшого обміну.
Після успішного встановлення захищеного з'єднання дані передаються в зашифрованому вигляді.
3.3. HTTPS — HTTP через захищене з'єднання
HTTPS — це використання HTTP із захистом, який забезпечує TLS.
Він допомагає гарантувати:
Конфіденційність: сторонні особи не повинні мати змоги прочитати вміст переданих даних.
Цілісність: дані мають бути захищені від непомітної зміни під час передавання.
Автентичність сервера: браузер може перевірити, чи відповідає сертифікат домену, до якого він підключається.
Наприклад, коли користувач вводить пароль або адресу доставки, HTTPS захищає ці дані під час передавання між браузером і сервером.
Однак HTTPS не гарантує, що сам сайт безпечний.
Він захищає канал зв'язку, але не усуває помилки в програмному коді, нечесні дії власника сайту або вразливості бази даних.
Важливе уточнення: описана послідовність TCP → TLS → HTTP характерна для HTTPS поверх TCP, зокрема HTTP/1.1 та HTTP/2. HTTP/3 використовує QUIC, який працює поверх UDP та інтегрує механізми TLS 1.3 у встановлення з'єднання.
Тому не кожне сучасне HTTPS-з'єднання проходить саме через окремий TCP handshake.
4. Браузер надсилає запит: як працює HTTP
Коли з'єднання готове, браузер може звернутися до вебсервера.
Для цього використовується HTTP — протокол, який визначає правила обміну запитами та відповідями між клієнтом і сервером.
4.1. HTTP-запит
Щоб отримати головну сторінку магазину, браузер надсилає HTTP-запит.
Спрощений приклад:
GET / HTTP/1.1

Host: shop.example.com

Accept: text/html
Розглянемо його складові:
GET — HTTP-метод, який вказує, що клієнт хоче отримати ресурс.
/ — шлях до ресурсу, у цьому випадку головної сторінки.
HTTP/1.1 — версія протоколу.
Host — домен, до якого спрямований запит.
Accept — інформація про типи вмісту, які клієнт готовий прийняти.
У реальному запиті можуть бути й інші заголовки, наприклад інформація про браузер, мову, cookies та формати стиснення.
4.2. HTTP-відповідь
Сервер отримує запит і повертає відповідь.
Наприклад:
HTTP/1.1 200 OK

Content-Type: text/html; charset=utf-8


<!DOCTYPE html>

<html>

<head>

    <title>Інтернет-магазин</title>

</head>

<body>

    <h1>Ласкаво просимо!</h1>

</body>

</html>
Тут:
200 OK — код статусу, який повідомляє про успішне виконання запиту;
Content-Type — заголовок, що вказує на тип вмісту;
HTML-код у тілі відповіді — документ, який браузер повинен обробити.
Не кожна відповідь означає успіх. Наприклад:
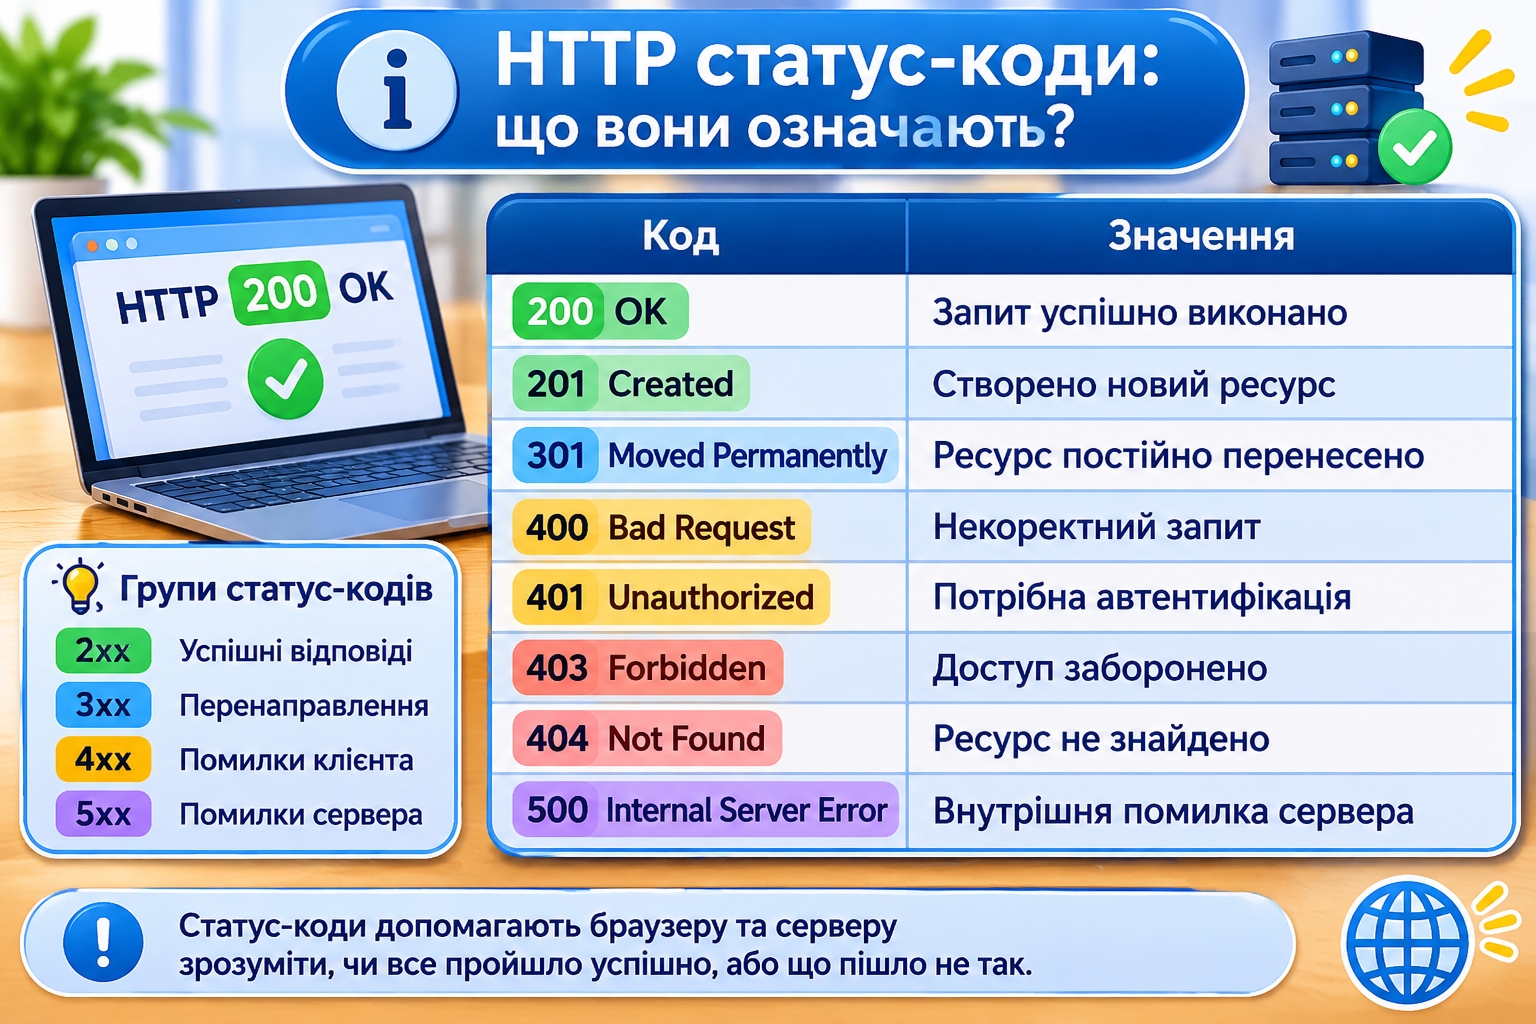
HTTP визначає не лише спосіб отримання сторінок.
Через нього також передають дані, надсилають форми, звертаються до API та виконують операції з ресурсами.
4.3. Чому одного запиту недостатньо?
Отримання HTML ще не означає, що браузер має все необхідне для відображення сторінки.
У документі можуть бути посилання на зовнішні ресурси:
<link rel="stylesheet" href="/styles.css">

<script src="/app.js" defer></script>

<img src="/images/product.jpg" alt="Товар">
Побачивши ці посилання, браузер надсилає додаткові HTTP-запити, щоб отримати CSS, JavaScript та зображення.
Отже, завантаження однієї сторінки часто складається з багатьох окремих запитів і відповідей.
5. Браузер будує сторінку: HTML, CSS та JavaScript разом
Після отримання HTML браузер починає перетворювати код на видиму сторінку.
Це не просте відображення текстового файлу. Браузер аналізує отримані ресурси, будує внутрішні структури та визначає, що саме потрібно показати користувачеві.
5.1. HTML створює структуру — DOM
Браузер читає HTML і будує DOM (Document Object Model) — об'єктну модель документа.
DOM можна уявити як дерево елементів сторінки.
Наприклад, HTML:
<body>

    <h1>Ноутбук</h1>

    <p>Ціна: 25 000 грн</p>

    <button>Додати до кошика</button>

</body>
Перетворюється на структуру, у якій body містить заголовок, абзац і кнопку.
JavaScript може звертатися до цих елементів, читати їхній вміст, змінювати його або створювати нові елементи.
5.2. CSS визначає зовнішній вигляд
Паралельно браузер обробляє CSS.
Він визначає, як повинні виглядати елементи:
кольори;
розміри;
шрифти;
відступи;
розташування;
адаптація до різних екранів.
CSS не створює зміст сторінки замість HTML. Він описує правила її оформлення.
5.3. JavaScript додає поведінку
JavaScript виконує програмний код, який може реагувати на дії користувача та змінювати сторінку.
Наприклад, він може:
обробити натискання кнопки;
перевірити заповнення форми;
відправити запит до сервера;
отримати дані про товар;
оновити кількість товарів у кошику;
показати повідомлення про результат операції.
5.4. Як усе перетворюється на зображення?
У спрощеному вигляді процес відображення сторінки має такі етапи:
Браузер аналізує HTML і створює DOM.
Обробляє CSS та створює CSSOM — об'єктну модель стилів.
Поєднує необхідні структури для побудови дерева відображення.
Розраховує розміри та розташування елементів — виконує layout.
Малює елементи та їхні стилі — виконує paint.
Формує остаточне зображення сторінки на екрані.
Цей процес може повторюватися, коли змінюється вміст або оформлення сторінки.
Важливо розуміти: HTML, CSS та JavaScript не конкурують між собою. Вони виконують різні завдання, які разом забезпечують роботу інтерфейсу.
6. Користувач взаємодіє зі сторінкою: що відбувається після натискання кнопки
Наш магазин уже відкритий. Користувач знайшов товар і натискає кнопку «Додати до кошика».
На перший погляд, це одна дія. Але браузер повинен виконати кілька операцій.
6.1. JavaScript обробляє подію
Натискання кнопки — це подія (event).
JavaScript може підписатися на цю подію та виконати потрібну функцію:
const button = document.querySelector("#add-to-cart");


button.addEventListener("click", () => {

    console.log("Користувач натиснув кнопку");

});
У цьому прикладі:
querySelector() знаходить кнопку на сторінці;
addEventListener() підписується на подію click;
функція всередині виконується після натискання.
Поки що код лише виводить повідомлення в консоль. Але замість цього він може запустити процес додавання товару до кошика.
6.2. Чи можна додати товар лише за допомогою JavaScript?
Технічно браузер може змінити зображення кошика, збільшити лічильник товарів або показати повідомлення.
Але це ще не означає, що товар справді збережено в системі.
Якщо JavaScript просто змінить число на екрані, інформація може зникнути після перезавантаження сторінки.
Щоб зберегти реальний стан кошика, вебзастосунок повинен передати відповідну інформацію серверу або використати інший механізм збереження.
У нашому прикладі JavaScript надсилає запит до API магазину.
7. API: як браузер спілкується із серверною частиною
API (Application Programming Interface) — це інтерфейс, який визначає, як різні програмні компоненти можуть взаємодіяти між собою.
У вебзастосунках API часто надає набір адрес і правил, за якими клієнт може звертатися до серверної частини.
Наприклад, магазин може мати такі маршрути:
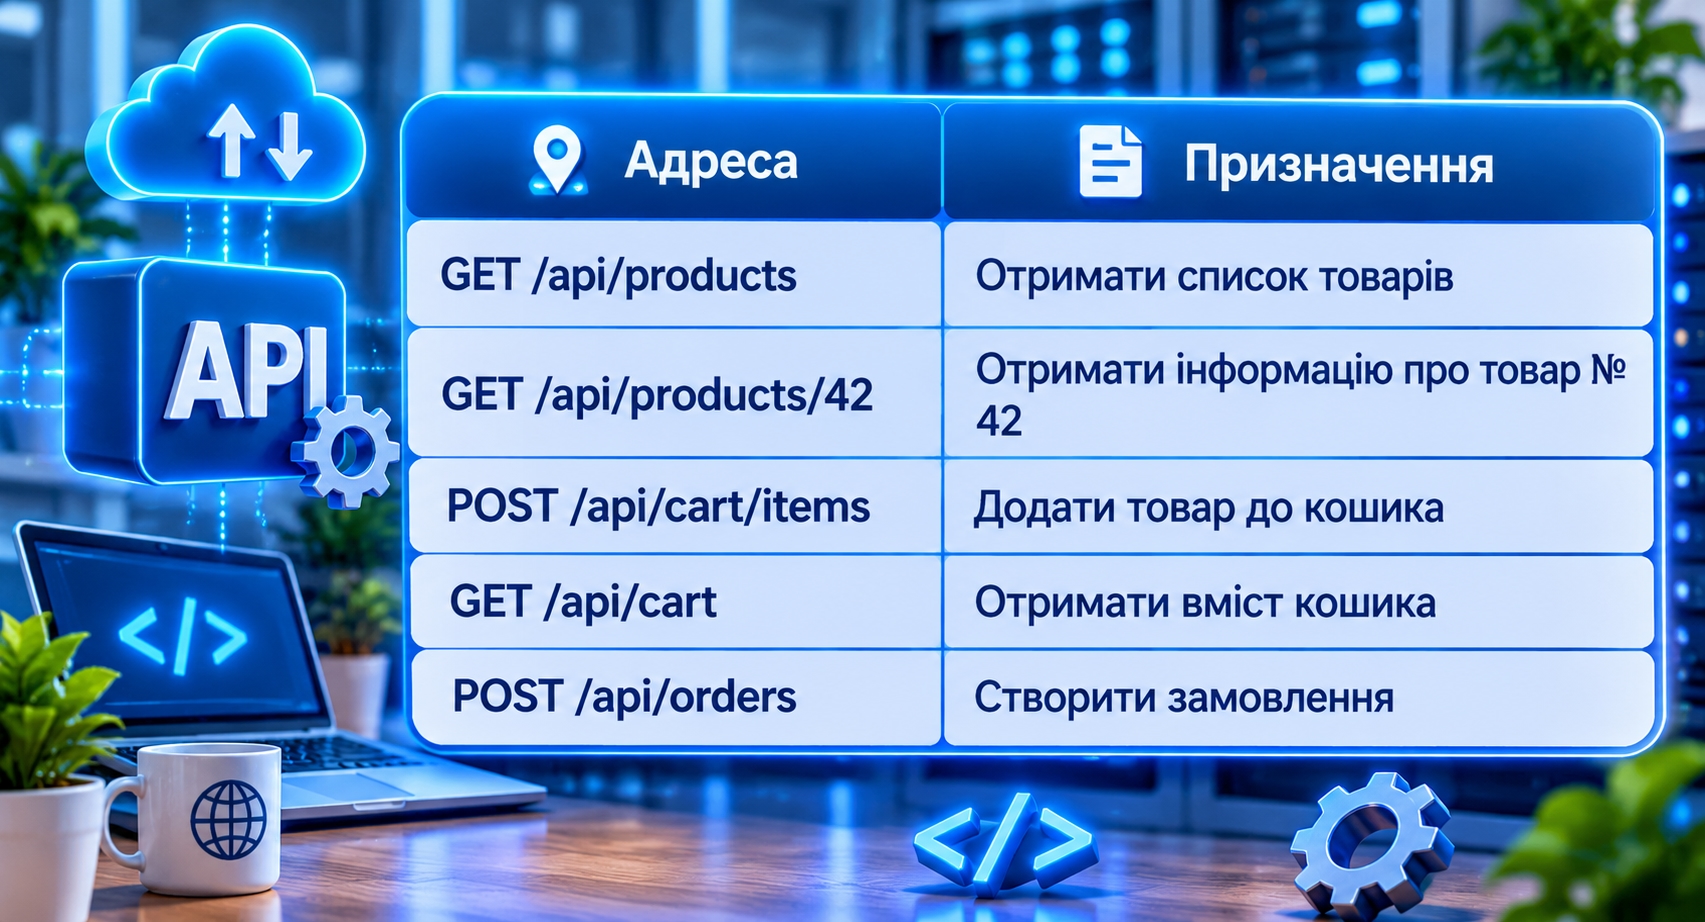
Це умовний приклад структури API. Реальні адреси та правила залежать від розробників конкретного магазину.
7.1. Запит до API за допомогою JavaScript
Коли користувач натискає кнопку, браузер може надіслати такий запит:
fetch("/api/cart/items", {

    method: "POST",

    headers: {

        "Content-Type": "application/json"

    },

    body: JSON.stringify({

        productId: 42,

        quantity: 1

    })

});
Що тут відбувається?
fetch() запускає мережевий запит.
method: "POST" вказує, що клієнт надсилає дані для створення або зміни ресурсу.
Content-Type повідомляє серверу, що тіло запиту містить JSON.
JSON.stringify() перетворює об'єкт JavaScript на текст у форматі JSON.
У тілі запиту передаються ідентифікатор товару та кількість.
Таким чином браузер передає серверу інформацію про дію користувача.
7.2. JSON — формат обміну даними
JSON (JavaScript Object Notation) — текстовий формат представлення структурованих даних.
Наприклад:
{

    "productId": 42,

    "name": "Ноутбук",

    "price": 25000,

    "quantity": 1

}
JSON зручний для обміну інформацією між різними програмами, оскільки має зрозумілу структуру та підтримується багатьма мовами програмування.
Важливо: JSON — це формат даних, а не протокол передавання.
У нашому випадку HTTP забезпечує обмін повідомленнями, а JSON визначає формат інформації всередині цих повідомлень.
8. Backend: що сервер робить із запитом
Запит надійшов до сервера. Тепер потрібно вирішити, що з ним робити.
Серверна програма отримує запит, аналізує його та виконує відповідну логіку.
У нашому випадку користувач хоче додати товар до кошика.
Backend може виконати такі кроки:
Визначити, до якого маршруту належить запит.
Перевірити, чи має користувач активну сесію або інший спосіб ідентифікації.
Перевірити правильність отриманих даних.
Знайти товар у базі даних.
Переконатися, що товар доступний.
Перевірити допустиму кількість.
Додати товар до кошика або оновити його кількість.
Підготувати відповідь для браузера.
8.1. Чому сервер повинен перевіряти дані самостійно?
Припустимо, браузер надсилає:
{

    "productId": 42,

    "quantity": 1,

    "price": 1

}
Користувач може спробувати змінити ціну товару, передавши замість реальної вартості лише одну гривню.
Якщо сервер без перевірки прийме цю інформацію, магазин матиме серйозну помилку.
Тому сервер повинен самостійно отримати актуальну ціну з довіреного джерела — наприклад, із бази даних — і виконати розрахунок.
Клієнт може передавати бажану дію, але сервер повинен перевіряти, чи дозволена вона та чи відповідають дані правилам системи.
8.2. Backend не обов'язково повинен повертати HTML
Сервер може повертати браузеру не цілу сторінку, а лише дані.
Наприклад, після успішного додавання товару він може відповісти:
{

    "success": true,

    "message": "Товар додано до кошика",

    "cartItemsCount": 3

}
Це дає змогу браузеру оновити лише потрібну частину інтерфейсу, не перезавантажуючи всю сторінку.
9. База даних: звідки сервер отримує та куди зберігає інформацію
Backend відповідає за логіку, але для роботи магазину йому потрібні дані.
Саме тут з'являється база даних.
9.1. Отримання інформації
Коли серверу потрібно перевірити товар із номером 42, він звертається до бази даних.
У реляційній базі даних це може виглядати так:
SELECT id, name, price, stock

FROM products

WHERE id = 42;
Цей SQL-запит означає:
SELECT — вибрати дані;
id, name, price, stock — потрібні поля;
FROM products — із таблиці products;
WHERE id = 42 — лише запис, у якого ідентифікатор дорівнює 42.
База даних повертає результат, а сервер використовує його для подальшої обробки.
9.2. Збереження інформації
Якщо товар потрібно додати до кошика, сервер може створити новий запис або змінити наявний.
Умовний приклад:
INSERT INTO cart_items (user_id, product_id, quantity)

VALUES (15, 42, 1);
Тут сервер зберігає інформацію про те, що користувач із номером 15 додав товар із номером 42 у кількості однієї одиниці.
У реальній системі операція може бути складнішою: потрібно враховувати наявний кошик, повторне додавання товару, транзакції та паралельні запити.
9.3. Чому браузер зазвичай не звертається до бази даних напряму?
У типовій архітектурі браузер не має прямого доступу до внутрішньої бази даних.
Між ними знаходиться серверна програма.
Це дає змогу:
контролювати доступ до інформації;
перевіряти права користувачів;
приховувати облікові дані бази;
перевіряти та обробляти запити;
застосовувати бізнес-правила;
не дозволяти клієнту довільно змінювати дані.
Таким чином, база даних зберігає інформацію, Backend керує операціями з нею, а API визначає, як інші компоненти звертаються до серверної логіки.
10. Cookies, сесії та автентифікація: як сайт пам'ятає користувача
HTTP за своєю базовою природою є протоколом без збереження стану (stateless).
Це означає, що кожен HTTP-запит розглядається як окреме повідомлення. Сам протокол не зберігає автоматично інформацію про те, хто надсилав попередній запит.
Але інтернет-магазину потрібно розуміти, хто саме користується сайтом, який кошик належить цій людині та чи має вона право оформити замовлення.
Для цього використовують механізми ідентифікації та керування станом.
10.1. Cookies
Cookie — це невеликий фрагмент даних, який браузер зберігає для певного сайту та може надсилати назад серверу відповідно до встановлених правил.
Наприклад, сервер може встановити cookie із випадковим ідентифікатором сесії.
Спрощений приклад заголовка відповіді:
Set-Cookie: session_id=abc123; Path=/; HttpOnly; Secure; SameSite=LaxТут:
session_id — назва cookie;
abc123 — умовне значення;
Path=/ означає, що cookie може надсилатися для всіх шляхів відповідного хоста.
HttpOnly — забороняє звичайному JavaScript читати цю cookie;
Secure — дозволяє передавати cookie лише через захищене HTTPS-з'єднання;
SameSite=Lax — обмежує надсилання cookie в частині міжсайтових сценаріїв.
Під час наступних відповідних запитів браузер може автоматично додавати цю cookie до HTTP-заголовків.
10.2. Сесія
Сесія — це механізм, який дає змогу пов'язувати кілька окремих запитів з одним користувачем або його взаємодією із сайтом.
У поширеній схемі:
Користувач входить у свій обліковий запис.
Сервер створює сесію.
Сервер передає браузеру ідентифікатор сесії через cookie.
Браузер надсилає цей ідентифікатор із наступними запитами.
Сервер знаходить відповідну сесію та визначає, з яким користувачем вона пов'язана.
Сам ідентифікатор не повинен містити пароль або інші відкриті конфіденційні дані.
10.3. Автентифікація та авторизація — у чому різниця?
Ці поняття часто плутають, хоча вони відповідають на різні запитання.
Автентифікація (Authentication) — перевірка того, ким є користувач.
Наприклад, людина вводить логін і пароль, а система перевіряє їхню правильність.
Авторизація (Authorization) — перевірка того, що користувачеві дозволено робити.
Наприклад, звичайний покупець може переглядати власні замовлення, але не повинен мати доступу до адміністративного керування товарами.
Отже, автентифікація відповідає на запитання «Хто ти?», а авторизація — «Що тобі дозволено?».
11. Безпека вебсайту: що потрібно захищати
Ми вже розглянули HTTPS, cookies, серверну перевірку даних та доступ до бази. Але безпека вебзастосунку не обмежується одним протоколом або налаштуванням.
Потрібно захищати всі частини системи: браузерний інтерфейс, API, серверну логіку, облікові записи та базу даних.
Розглянемо кілька поширених типів загроз.
11.1. XSS — виконання шкідливого коду в браузері
XSS (Cross-Site Scripting) — клас вразливостей, за яких зловмисник може домогтися виконання небажаного JavaScript-коду в контексті сторінки сайту.
Наприклад, якщо магазин безпечно не обробляє відгуки користувачів, зловмисник може спробувати вставити в них шкідливий код.
Якщо сайт неправильно відобразить цей вміст, браузер може сприйняти його не як звичайний текст, а як код.
Наслідками можуть бути викрадення доступу до облікового запису, підміна вмісту сторінки або виконання дій від імені користувача.
Для захисту застосовують контекстне кодування виводу, безпечні методи роботи з DOM, санітизацію HTML там, де вона потрібна, та додаткові механізми захисту.
Навіть якщо cookie захищена атрибутом HttpOnly, XSS може залишатися небезпечною: шкідливий код здатний виконувати дії від імені користувача в межах його активної сесії.
Тому HttpOnly знижує окремі ризики, але не усуває саму вразливість XSS.
11.2. CSRF — підроблення міжсайтових запитів
CSRF (Cross-Site Request Forgery) — атака, за якої зловмисник намагається змусити браузер авторизованого користувача надіслати небажаний запит до сайту, де цей користувач уже має активну сесію.
Наприклад, людина увійшла в інтернет-магазин. Якщо система неправильно захищає операції, стороння сторінка може спробувати ініціювати дію від її імені.
Для зниження ризику використовують CSRF-токени, перевірку походження запитів, відповідні налаштування cookies та інші захисні механізми.
11.3. SQL Injection — втручання в SQL-запити
SQL Injection виникає, коли програма небезпечно включає дані користувача в SQL-запит.
Наприклад, якщо сервер просто з'єднує текст запиту з отриманим від користувача значенням, зловмисник може спробувати змінити логіку SQL-команди.
Наслідками можуть бути несанкціоноване читання, зміна або видалення даних.
Основний спосіб захисту — параметризовані запити та використання безпечних механізмів доступу до бази даних.
11.4. CORS — контроль міждоменних запитів
CORS (Cross-Origin Resource Sharing) — механізм, за допомогою якого сервер повідомляє браузеру, чи дозволено вебсторінкам з інших джерел читати відповіді на запити до нього.
Наприклад, якщо frontend магазину розміщений на одному домені, а API — на іншому, розробники повинні правильно налаштувати політику CORS.
Важливо не плутати CORS із системою автентифікації або авторизації. CORS не замінює перевірку особи користувача та його прав на сервері.
Це механізм, який регулює доступ браузерного JavaScript до відповідей із різних джерел.
11.5. Безпека — це сукупність заходів
Жоден окремий механізм не робить сайт повністю безпечним.
HTTPS захищає передавання даних, але не виправляє SQL Injection. CSRF-токен не усуває XSS. CORS не замінює авторизацію.
А правильна робота з cookies не гарантує безпеки всієї серверної частини.
Захист повинен враховувати архітектуру всього застосунку, а не лише окремі технології.
12. Де все це працює: вебсервер, хостинг і розміщення сайту
Ми простежили шлях інформації від браузера до серверної програми та бази даних. Тепер потрібно зрозуміти, де фізично та програмно розміщені ці компоненти.
12.1. Сервер — не обов'язково один комп'ютер
У невеликому проєкті вебсервер, Backend і база даних можуть працювати на одній машині.
Але зі зростанням кількості користувачів такої архітектури може бути недостатньо.
Тоді компоненти розділяють:
один сервер обслуговує вебзапити;
інший виконує серверну логіку;
окремий сервер або кластер зберігає базу даних;
додаткові системи відповідають за кешування, обробку файлів, резервні копії та інші завдання.
Це дає змогу незалежно масштабувати компоненти.
За умови правильного резервування та налаштування відмовостійкості така архітектура також може підвищувати надійність системи.
12.2. Вебсервер і Backend — не одне й те саме
Вебсервер — програмне забезпечення, яке приймає HTTP-запити та повертає відповіді.
Він може безпосередньо віддавати статичні файли, наприклад HTML, CSS, JavaScript і зображення, або передавати динамічні запити серверній програмі.
Backend — це програмна логіка самого вебзастосунку.
Наприклад, вебсервер може отримати запит /api/orders, передати його Backend, а той перевірить користувача, обробить замовлення та звернеться до бази даних.
12.3. Хостинг
Хостинг — послуга або інфраструктура, яка надає ресурси для розміщення сайту та забезпечення його доступності через мережу.
Це може бути:
звичайний віртуальний хостинг;
віртуальний приватний сервер (VPS);
виділений фізичний сервер;
хмарна платформа;
керована інфраструктура для вебзастосунків.
Вибір залежить від потреб проєкту, навантаження, бюджету та вимог до контролю над сервером.
12.4. Домен і DNS
Доменне ім'я дає користувачам зручний спосіб знаходити сайт.
DNS пов'язує домен із потрібною мережевою інфраструктурою.
Наприклад, записи DNS можуть вказувати на IP-адреси серверів або на інші доменні імена, через які організовано доступ до сайту.
Тому домен, DNS, хостинг і вебсервер — різні складові, які працюють разом, але не є взаємозамінними.
13. Наскрізний сценарій: від відкриття магазину до оформлення замовлення
Тепер об'єднаємо всі розглянуті компоненти в одну послідовність.
Уявімо, що користувач хоче придбати ноутбук.
Етап 1. Відкриття сайту
Користувач вводить адресу інтернет-магазину в браузері.
Браузер визначає доменне ім'я.
DNS допомагає знайти IP-адресу потрібної інфраструктури.
Браузер встановлює мережеве з'єднання.
TLS забезпечує захищений канал для HTTPS-запитів.
Етап 2. Завантаження сторінки
Браузер надсилає HTTP-запит на отримання головної сторінки.
Вебсервер приймає запит.
Сервер повертає HTML-документ.
Браузер аналізує HTML і створює DOM.
Браузер завантажує CSS, JavaScript, зображення та інші необхідні ресурси.
HTML і CSS формують структуру та зовнішній вигляд сторінки.
JavaScript забезпечує інтерактивність.
Етап 3. Перегляд товару
Користувач відкриває сторінку ноутбука.
Браузер надсилає запит до API.
Backend отримує запит і звертається до бази даних.
База даних повертає інформацію про товар.
Backend формує відповідь, наприклад у форматі JSON.
Браузер отримує дані та відображає назву, ціну, опис і наявність товару.
Етап 4. Додавання товару до кошика
Користувач натискає кнопку «Додати до кошика».
JavaScript обробляє подію натискання.
Браузер надсилає POST-запит до API.
Сервер перевіряє отримані дані та ідентифікує користувача.
Backend перевіряє товар, його наявність і допустиму кількість.
Сервер звертається до бази даних та зберігає зміни.
Backend повертає результат операції.
JavaScript оновлює лічильник товарів і вміст кошика.
Етап 5. Оформлення замовлення
Користувач переходить до оформлення замовлення.
Браузер надсилає запит із даними, необхідними для створення замовлення.
Сервер перевіряє сесію користувача та його права.
Backend повторно перевіряє актуальні ціни, наявність товарів та інші умови.
Сервер виконує необхідні операції з базою даних.
Замовлення зберігається, а система присвоює йому номер і початковий статус.
Сервер повертає браузеру результат.
Користувач бачить підтвердження оформлення замовлення.
Цей сценарій показує, що звичайна дія в інтерфейсі може запускати цілий ланцюг взаємодій між різними компонентами.
14. Загальна архітектура: як усі компоненти пов'язані між собою
Спробуємо звести весь процес до однієї схеми.
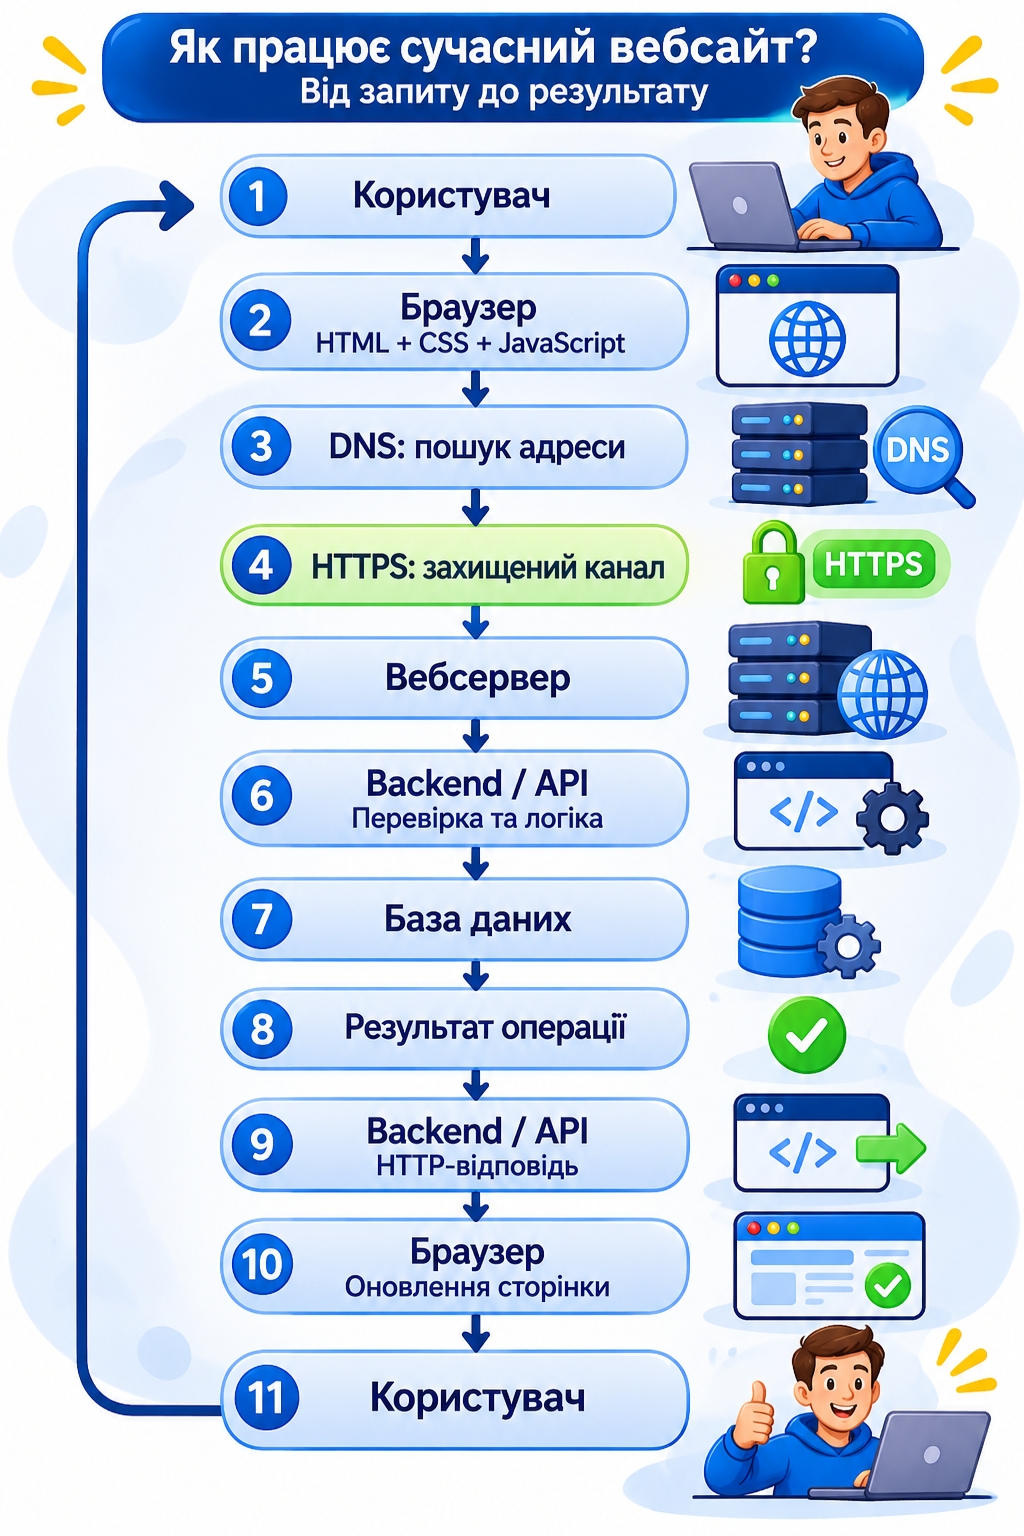
Це спрощена логічна схема. DNS і встановлення HTTPS-з'єднання не є обов'язково окремими послідовними сервісами всередині кожного запиту:
DNS потрібен для пошуку мережевої адреси, а захищене з'єднання встановлюється перед обміном відповідними HTTP-повідомленнями. Після цього з'єднання може повторно використовуватися для багатьох запитів.
Також у реальних системах можуть бути проміжні компоненти: CDN, кеші, балансувальники навантаження, проксі-сервери та системи моніторингу. Вони не змінюють основної ідеї, але роблять архітектуру складнішою та ефективнішою.
15. Хто за що відповідає: коротка карта технологій
Після проходження всього сценарію корисно ще раз розмежувати ролі основних технологій.
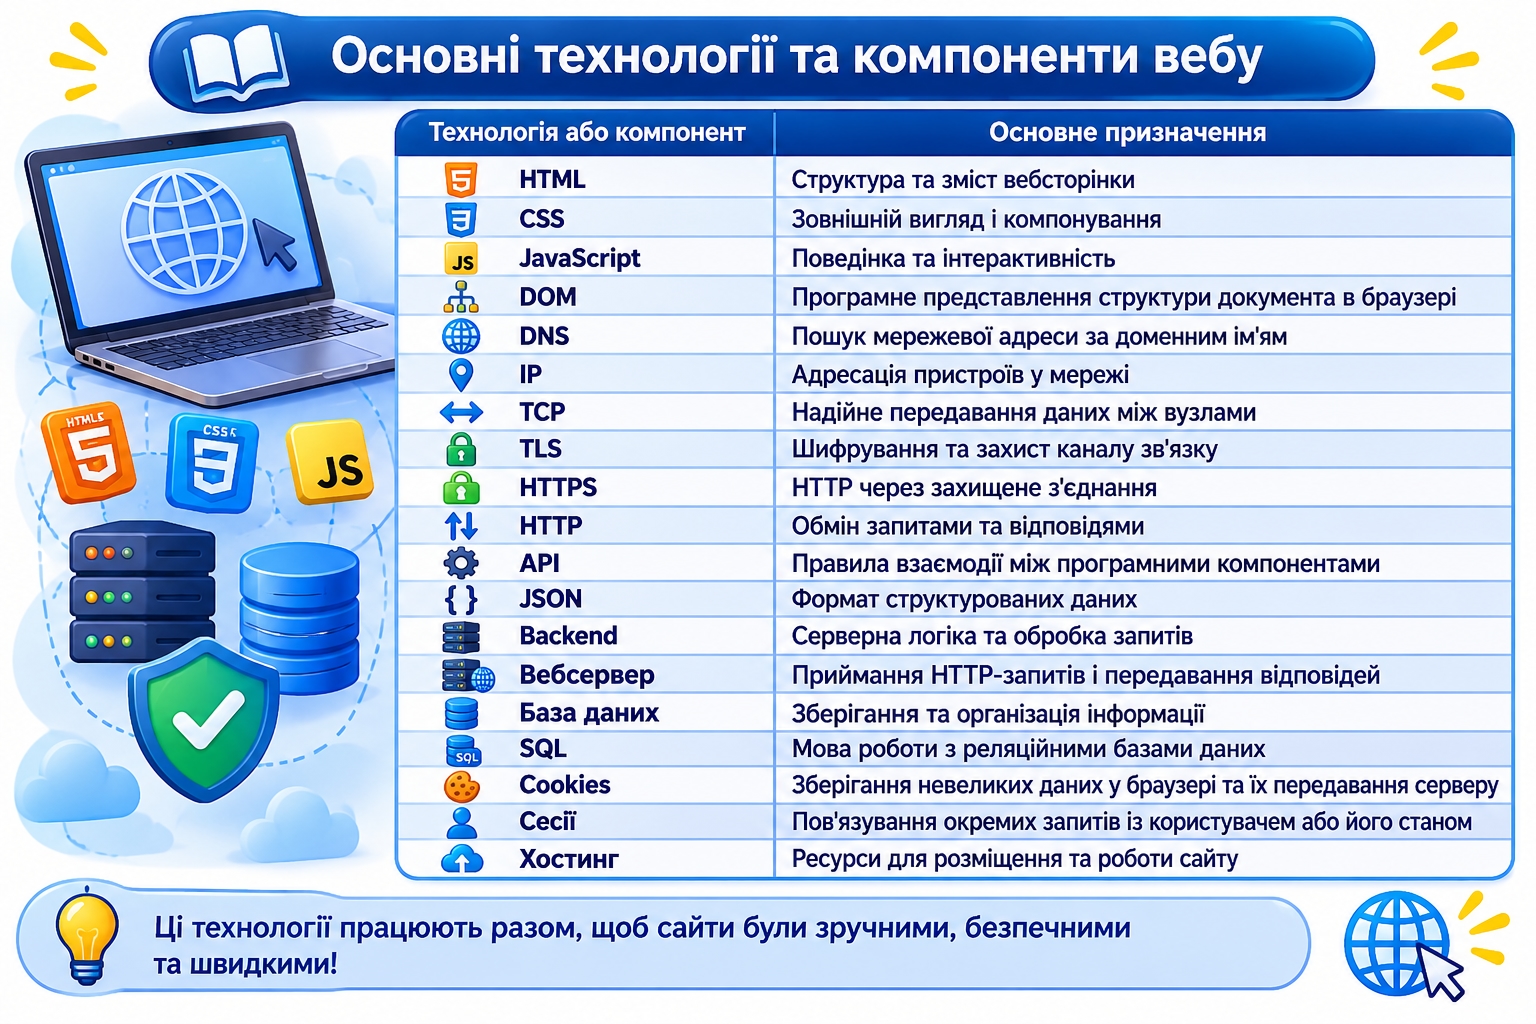
Головне — не запам'ятати таблицю механічно, а зрозуміти взаємозалежність компонентів.
Наприклад:
HTML не замінює CSS, тому що структура та оформлення — різні завдання.
CSS не замінює JavaScript, тому що зовнішній вигляд не дорівнює програмній поведінці.
JavaScript у браузері не замінює Backend, тому що клієнтському коду не можна довіряти виконання всіх захищених операцій.
API не є базою даних, тому що API визначає спосіб взаємодії, а база даних зберігає інформацію.
HTTPS не замінює безпеку вебзастосунку, тому що захищений канал не усуває вразливості програмного коду.
DNS не є хостингом, тому що пошук адреси та розміщення сайту — різні функції.
16. Висновок: вебсайт як система взаємодії
Сучасний вебсайт — це не окрема сторінка та не одна програма. Це система, у якій браузер, мережеві протоколи, серверне програмне забезпечення та бази даних взаємодіють за визначеними правилами.
Коли користувач відкриває сайт, браузер знаходить потрібну адресу, встановлює з'єднання та отримує ресурси. HTML, CSS і JavaScript формують інтерфейс.
Коли користувач виконує дію, JavaScript може надіслати запит до API. Backend перевіряє його, виконує потрібну логіку, звертається до бази даних і повертає результат. Браузер отримує відповідь та оновлює те, що бачить людина.
У цьому процесі кожна технологія має власну роль. Жодна не повинна виконувати роботу всіх інших.
Саме тому розуміння вебу починається не з механічного запам'ятовування назв HTML, CSS, JavaScript, HTTP або DNS.
Воно починається тоді, коли ми бачимо, як ці компоненти пов'язані між собою та як спільно забезпечують роботу звичайного вебсайту.
Якщо дев'ять попередніх статей допомогли розібратися з окремими частинами вебу, то ця стаття об'єднує їх в одну картину.