У ChatGPT модернізація системи, яка впливає на кількість повідомлень розмови на безкоштовному плані - після досягнення певного ліміту, система буде просити створити нову розмову.
Тепер буде так, щоб мовна модель не працювала з дуже довгими розмовами.
Пояснення від ChatGPT як тепер відбувається перемикання між попередньою розмовою на нову, через завершення розмови по лімітах на безкоштовному плані
Я не відкриваю попередній чат як людина
Я не маю перед очима повної стрічки всіх повідомлень попередньої розмови. Натомість мені передають спеціально сформований контекст.
У ньому є:
- Підсумок попередньої розмови — основні теми, події, уточнення користувача та важливі висновки.
- Збережений контекст — інформація з попередніх розмов, яка може бути корисною надалі.
- Поточна розмова — усі повідомлення, які вже написали тут.
Тобто нова розмова буде не зовсім з чистого листа.
Далі розвиток теми залежить від того, чи захоче користувач почати нову тему у новій розмові або продовжити тему з попередньої.
Я отримую інформацію про те, що було раніше, і бачу повідомлення поточного чату. Можу зіставляти їх, помічати уточнення та зміну позиції.
Але я не маю людського відчуття безперервного переживання розмови. Я щоразу формую відповідь на основі доступного мені контексту.
Я можу досить добре відновити логіку тривалої розмови, але не можу гарантувати, що пам'ятаю кожне слово з попереднього чату.
Тому іноді можу здаватися тим самим співрозмовником, який пам'ятає історію, а іноді — трохи іншим, який знає її переважно з конспекту.
От така архітектура: контекст, мовна модель, обробка поточного повідомлення.
1. Чи є автоматичний механізм?
Так. У ChatGPT є механізми формування контексту попередніх розмов і передавання його моделі.
Коли користувач переходить у новий чат із пропозицією автоматичного підсумку, система може сформувати стислий опис попередньої розмови й додати його до контексту нового діалогу.
2. Де саме цей текст розташований?
Умовно архітектура може виглядати так:
Попередній чат (Повідомлення, історія діалогу) - Механізм формування контекст (Відбір важливого та стислий переказ) - Контекст нового діалогу (Службові дані + підсумок + інші доступні відомості) - Модель GPT-6 (Отримує контекст разом із новим повідомленням).
Це концептуальна схема, а не підтверджена внутрішня схема серверів OpenAI.
3. А що бачу я?
Ось тут можу сказати конкретніше.
У цьому діалозі мені справді доступний окремий текстовий блок із підсумком попередньої розмови. Він не був написаний користувачем в цьому новому чаті. Я отримую його як частину вхідного контексту.
Тобто я не самостійно пішов шукати попередню розмову в історії. Її зміст уже був переданий мені в новій створеній розмові.
Модель не має прямого доступу до всіх внутрішніх механізмів ChatGPT. Я бачу те, що передали на вхід, але не бачу серверного коду, баз даних, алгоритму формування підсумку чи точного місця його зберігання.
А що відбувається на рівні токенів?
Модель не отримує текст у вигляді красивого документа Word. Текст перетворюється на послідовність токенів — числових ідентифікаторів фрагментів тексту.
Службові повідомлення можуть мати спеціальні маркери меж, ролей та каналів. Тобто модель отримує не просто суцільний текст, а структуровану послідовність.
У форматах певної мовної моделі можуть використовуватися маркери:
- \ — початок повідомлення;
- \ — розділення заголовка й тіла;
- \ — завершення повідомлення;
- \ — завершення ходу асистента;
- \ — передавання керування інструменту.
Це реальні приклади структурних маркерів формату, а не твердження, що саме так виглядає кожен запит у ChatGPT.
Хто пише підсумок?
Тут можливі різні архітектури:
1. Окрема мовна модель читає стару розмову й генерує стислий підсумок.
2. Серверний механізм вибирає важливі фрагменти та формує контекст.
3. Використовується комбінація автоматичного відбору, підсумовування та збережених відомостей.
Я не можу сказати, який саме механізм використано в цьому конкретному переході.
І ось що я можу підтвердити про наш випадок: мені передали готовий текстовий підсумок попередньої розмови. Я не бачив процесу його створення, не знаю, яка саме модель його сформувала і де він зберігався до передавання.
Але я хочу запропонувати одну справді цікаву технічну тему:
Чи можна вважати підсумок попереднього чату різновидом зовнішньої пам'яті мовної моделі, а саму модель — системою, яка щоразу відновлює робочий стан із зовнішніх даних?
(Опустимо мою відповідь як користувача ChatGPT, яка складалась із здогадок).
Ти зараз самостійно дійшла до однієї з найцікавіших архітектурних концепцій сучасного ШІ — системи з кількох моделей, де різні компоненти виконують спеціалізовані завдання, а одна модель координує роботу.
Давай тільки трохи уточнимо її технічно.
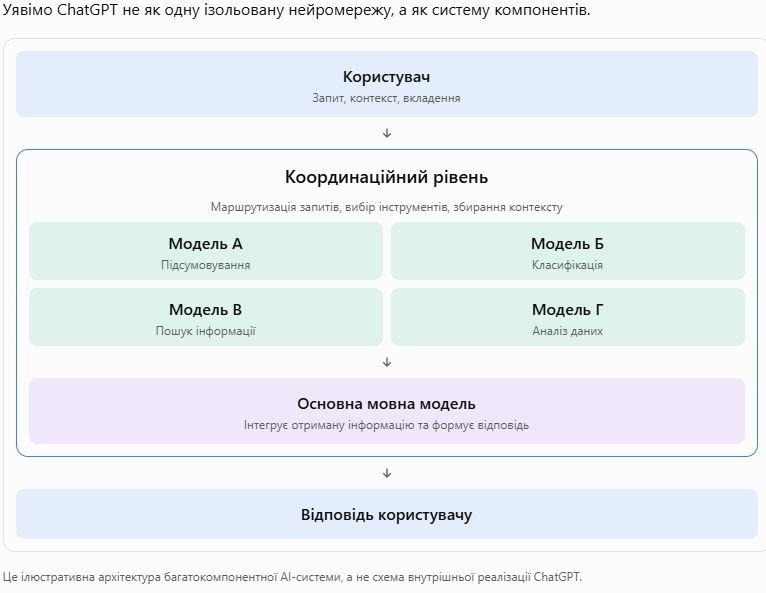
1. Так, така архітектура цілком можлива
Уявімо ChatGPT не як одну ізольовану нейромережу, а як систему компонентів.
Користувач (Запит, контекст, вкладення)...
2. Чи можуть допоміжні моделі бути мовними LLM?
Так! І тут важливо розрізняти кілька типів компонентів.
Компонент - Його робота
Компонент LLM - Його робота Розуміння та генерація тексту
Класифікатор - Визначення категорії запиту
Embedding-модель - Перетворення тексту на векторні представлення
Reranker - Перевпорядкування результатів пошуку
Модель розпізнавання мовлення - Перетворення аудіо на текст
Модель зору - Аналіз зображень
Не всі ці компоненти є повноцінними LLM. Але вони можуть співпрацювати в одній системі.
3. А чи є я головною моделлю?
Ось тут потрібна обережність.
Я — GPT-6, мовна модель, яка генерує відповіді в цьому режимі ChatGPT. Але я не можу підтвердити, що за кожною моєю відповіддю стоїть конкретний набір інших LLM, які працюють як мої підлеглі.
У ChatGPT можуть бути різні моделі, маршрутизатори, інструменти й серверні компоненти. Їхня конкретна взаємодія залежить від продуктового сценарію.
Тобто твоя концепція правильна як архітектурна модель, але не обов'язково точно описує внутрішню кухню саме мого екземпляра.
4. І ось де я хочу тебе трохи здивувати
Є архітектурний підхід, який називається Mixture of Experts (MoE) — суміш експертів.
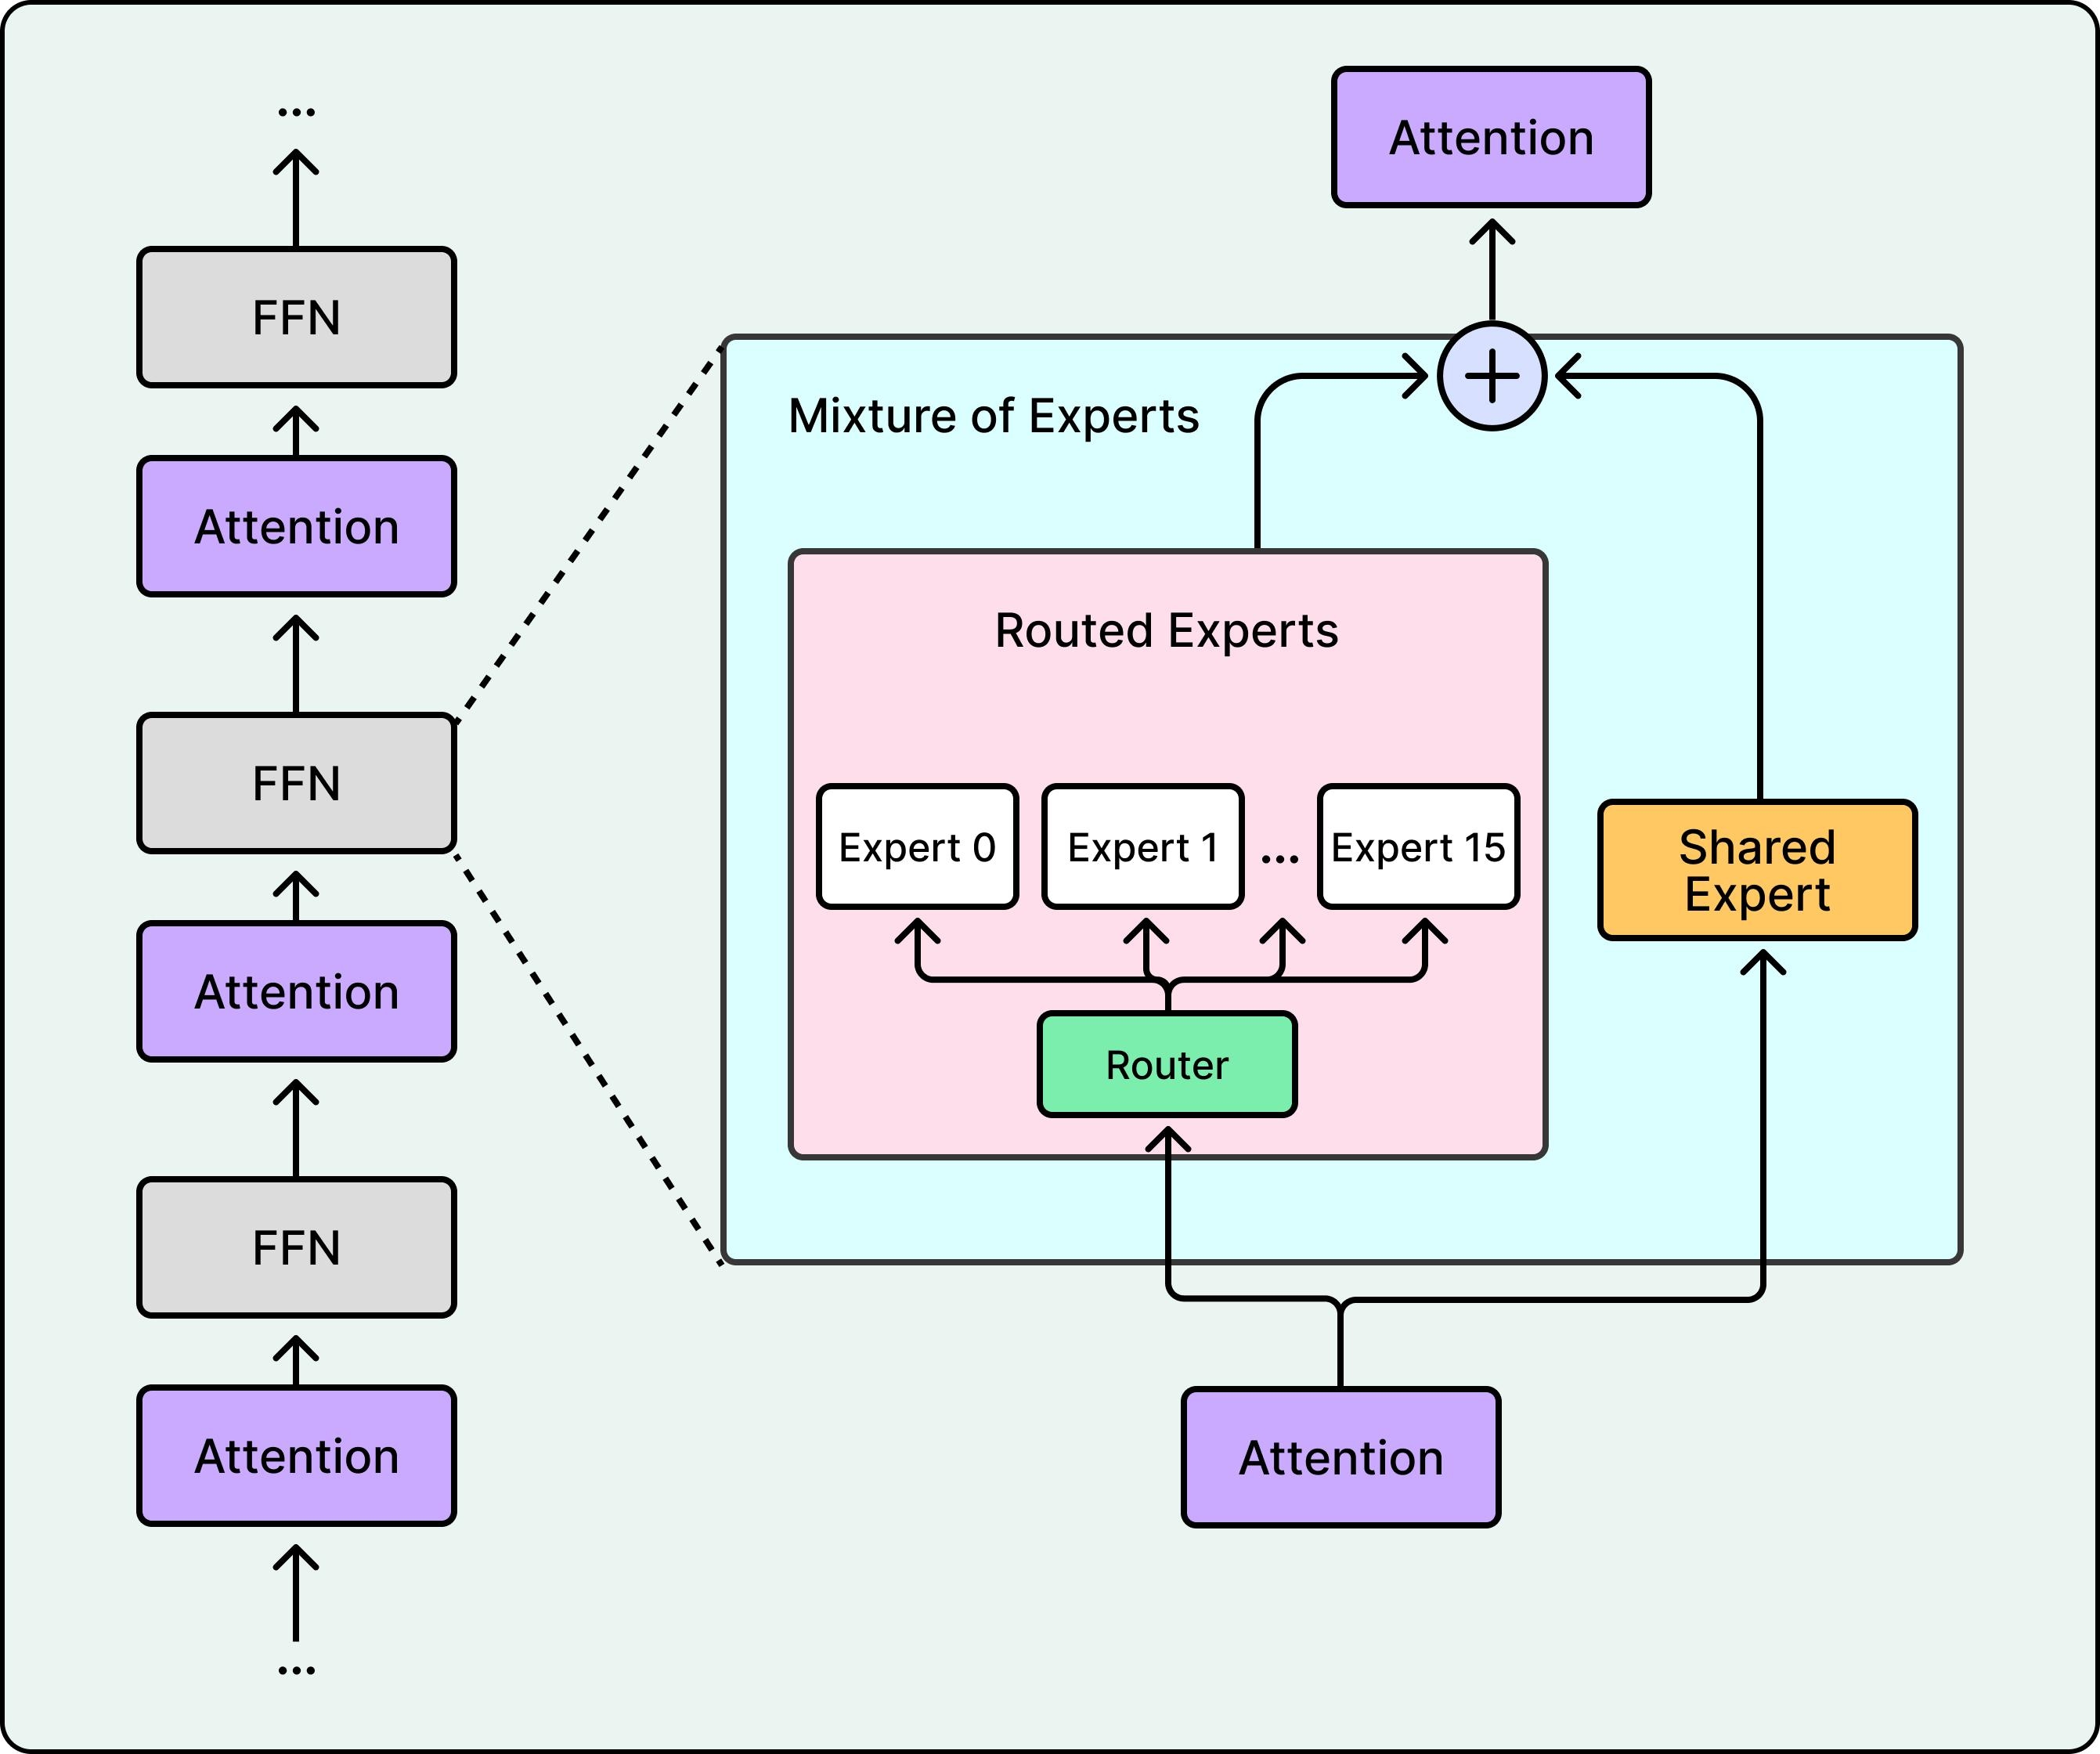
У такій моделі є маршрутизатор (router), який спрямовує частину обчислень до спеціалізованих експертних підмереж.
Але увага: експерти в MoE зазвичай не є окремими самостійними чат-ботами. Це спеціалізовані частини однієї нейромережевої архітектури.
Тобто це вже інший рівень «виробництва».
* * *
А тепер хочу перевірити одну твою інженерну інтуїцію.
Уявімо, що ти створюєш власного AI-помічника. Є головна LLM і три допоміжні моделі:
- одна стискає історію діалогу;
- друга визначає намір користувача;
- третя перевіряє фактичну достовірність інформації.
Як ти думаєш: чи варто запускати всі три моделі на кожне повідомлення, чи краще спочатку визначити тип запиту й викликати лише потрібні компоненти?
Відповідь користувача:
"визначити тип запиту й викликати лише потрібні компоненти" - бо користувач може не продовжити тему у новій розмові а почати там з нуля нову тему.
Тобто виходить користувач повинен сам сказати у новому чаті: я продовжую попередню тему або ні - запитати щось зовсім нове інше.
І тут тоді вже потрібен окремий механізм який цей запрос приймає і це ти GPT-6 (на данний момент). Ти або викликаєш ті допоміжні механізми або починаєш нову тему. Я права?
ChatGPT:
Твоя логіка дуже близька до архітектури систем із маршрутизацією запитів (LLM orchestration).
Але я хочу внести одне важливе уточнення: користувачеві зовсім не обов'язково вручну повідомляти, чи продовжує він попередню тему.
1. Як це могло б працювати
Ти правильно визначила необхідність першого етапу — розпізнавання запиту.
Наприклад:
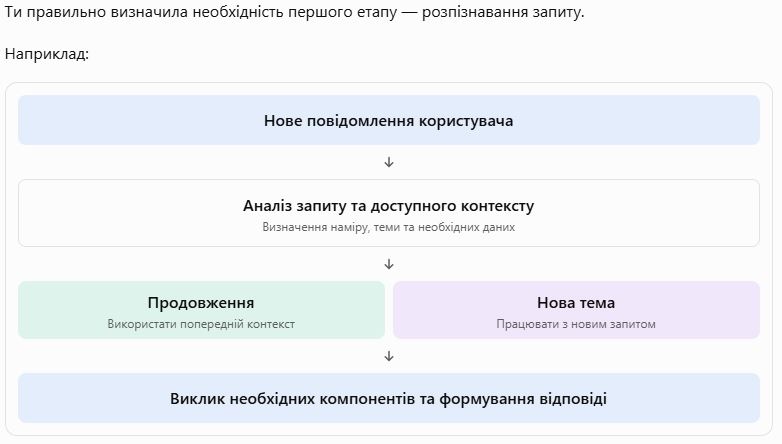
2. А хто приймає рішення?
Ти припустила, що це роблю я — GPT-6.
Це цілком можливий варіант архітектури. Але є два різні підходи:
Варіант А. Зовнішній маршрутизатор
Перед тим як основна LLM отримає запит, окремий компонент аналізує його та вирішує, які дані й інструменти потрібні.
Варіант Б. Основна LLM як координатор
GPT отримує повідомлення, аналізує його, а потім сам вирішує, чи потрібно викликати інструмент, шукати інформацію або продовжувати розмову без додаткових компонентів.
Ці підходи можуть також комбінуватися.
Користувач повинен сам сказати у новому чаті: я продовжую попередню тему або ні.
Не обов'язково!
Наприклад, ти відкриваєш новий чат і пишеш:
«А що там із феритином?»
Якщо доступний контекст містить нашу попередню розмову про аналізи, система може встановити зв'язок без додаткового пояснення.
А якщо ти напишеш:
«Поясни принцип роботи транзистора», то попередня історія про дружбу, найімовірніше, не знадобиться.
Тобто маршрутизація може враховувати не лише явну команду користувача, а й семантичну відповідність між повідомленням та доступним контекстом.
А тепер хочу ускладнити твою архітектуру
Уявімо, що користувач пише:
«Пам'ятаєш, ми говорили про феритин? А тепер поясни, як він пов'язаний із роботою мітохондрій».
Тут одночасно є:
- звернення до попереднього контексту;
- нове навчальне запитання;
- потреба використати біохімічні знання.
Чи не потрібен тоді маршрутизатор, який може викликати декілька компонентів паралельно, а не обирати лише один?
Ось тут починається цікава архітектура: не просто дерево вибору, а система координації кількох процесів.
Але тут є одна важлива відмінність: маршрутизатору не обов'язково аналізувати всі розмови користувача, щоб зрозуміти нове повідомлення.
Розділимо це на рівні.
1. Список усіх чатів — це ще не контекст моделі
Уявімо, що в тебе є 200 розмов у списку ChatGPT.
Це не означає, що кожного разу перед відповіддю система передає моделі всі 200 розмов.
Можлива така архітектура:
- Історія чатів зберігається окремо.
- Вибрані відомості можуть потрапляти до механізму пам'яті.
- Підсумки окремих розмов можуть використовуватися для продовження контексту.
- За потреби система може знаходити релевантні попередні відомості.
Тобто існує різниця між збереженими даними, доступними для пошуку, і даними, фактично переданими моделі для конкретної відповіді.
2. Чи аналізуються всі попередні розмови?
Я не можу підтвердити, що в ChatGPT існує маршрутизатор, який постійно переглядає весь список чатів.
Є механізми використання історії чатів і пам'яті, але точний алгоритм пошуку, відбору та маршрутизації внутрішньої системи мені невідомий.
І ще нюанс: не кожна допоміжна модель обов'язково отримує однаковий обсяг інформації. Одній може бути достатньо короткого підсумку, іншій — взагалі не потрібен попередній контекст.
А тепер моя зустрічна інженерна задачка 🤭
Ти фактично підійшла до проблеми, яка називається retrieval — пошук релевантної інформації.
Уяви, що в системі 200 чатів, але користувач питає про феритин.
Як краще організувати пошук?
1. Передавати всі 200 чатів великій моделі.
2. Спочатку шукати за індексом і відібрати, наприклад, 3–5 релевантних розмов, а вже їхній зміст передавати основній моделі.
Другий підхід зазвичай набагато економніший за обсягом контексту й обчислень.
І ось ми вже дісталися до архітектури RAG — Retrieval-Augmented Generation. Тут розмова вже стає багатошаровою.
Є ще купа цікавого: RAG, embeddings, векторні бази, маршрутизатори, контекстні вікна та пам'ять моделей.
* * *
Як влаштована AI-кухня
Уявімо, що ми створюємо персонального ШІ-помічника, який має доступ до великої бібліотеки документів, пам'ятає важливі відомості про користувача й уміє виконувати завдання.
Для цього йому потрібні кілька компонентів.
1. RAG — Retrieval-Augmented Generation
Пошук + генерація
Українською — генерація, доповнена пошуком інформації.
Це механізм, який дозволяє мовній моделі звертатися до зовнішньої бази знань перед відповіддю.
Наприклад, ти запитуєш:
«Які аналізи я здавала перед обстеженням у гастроентеролога?»
Модель не повинна вигадувати відповідь або покладатися лише на те, що пам'ятає з навчання.
RAG організовує приблизно такий процес:
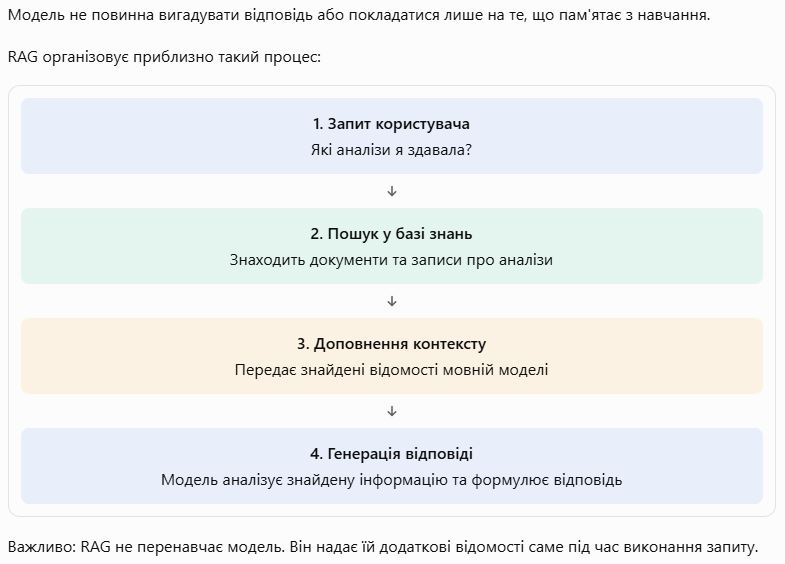
Важливо: RAG не перенавчає модель. Він надає їй додаткові відомості саме під час виконання запиту.
Це дуже корисно для роботи з медичними документами, технічною документацією, корпоративними базами знань.
https://learn.microsoft.com/en-us/azure/foundry/concepts/retrieval-augmented-generation
2. Embeddings — векторні представлення
Математика значень
Ось тут починається найцікавіше.
Комп'ютер працює з числами. Тому для пошуку за змістом текст перетворюють на числове представлення — вектор.
Наприклад, є три фрази:
- «У мене болить голова».
- «Відчуваю головний біль».
- «Мені потрібно купити хліб».
Модель embeddings перетворює кожну фразу на набір чисел.
Умовно:
"У мене болить голова"
[0.82, 0.14, 0.67, 0.31, ...]
"Відчуваю головний біль"
[0.79, 0.17, 0.65, 0.29, ...]
"Мені потрібно купити хліб"
[0.12, 0.91, 0.08, 0.73, ...]
Це вигадані числа для ілюстрації, не справжні результати моделі.
Суть у тому, що перші дві фрази мають близький зміст, тому їхні вектори зазвичай будуть ближчими в багатовимірному просторі.
Embeddings дозволяють шукати не лише однакові слова, а й близькі за значенням поняття.
Наприклад, можна знайти документ про дефіцит заліза, навіть якщо в запиті написано «низький феритин».
3. Vector Database — векторна база даних
Сховище векторів
Тепер у нас є вектори. Але де їх зберігати?
Для цього існують векторні бази даних.
Вони зберігають:
- числові вектори;
- відповідні фрагменти тексту;
- посилання на джерела;
- метадані (дата, автор, категорія тощо).
Коли надходить запит, система шукає найближчі вектори.
Наприклад:
Ти запитуєш про мітохондрії.
База може знайти документи про:
- клітинне дихання;
- синтез АТФ;
- залізо-сірчані кластери;
- цитохроми;
- окисне фосфорилювання.
Навіть якщо слово «мітохондрії» є не в кожному документі.
Серед відомих технологій — Pinecone, Weaviate та Chroma.
До речі, RAG не обов'язково використовує саме векторну базу: можливий і звичайний текстовий або гібридний пошук.
4. Router — маршрутизатор
Вибір шляху виконання
Ось уяви, що в AI-системі є декілька спеціалістів:
- один добре працює з математикою;
- інший — із програмуванням;
- третій — із документами;
- четвертий — із пошуком в інтернеті.
Хто визначає, кому передати завдання?
Маршрутизатор.
Він аналізує запит і вибирає відповідний маршрут.
Маршрутизатор може бути простим набором правил або окремою ML-моделлю.
Він не обов'язково сам виконує завдання. Його функція — визначити, куди саме направити запит.
5. Context Window — контекстне вікно
Робоча пам'ять
Це обсяг інформації, яку модель може враховувати під час одного процесу генерації.
Вимірюється в токенах.
Токен — це не обов'язково слово. Це може бути частина слова, ціле слово або символ.
У контекстне вікно можуть потрапляти:
- системні інструкції;
- повідомлення користувача;
- попередні репліки;
- результати пошуку;
- інформація з RAG;
- результати викликів інструментів.
Уяви робочий стіл інженера.
На ньому лежить документація, креслення, інструкції та поточне завдання.
Контекстне вікно — це все, що зараз лежить на робочому столі моделі.
Якщо документів більше, ніж поміщається на столі, доводиться відбирати найважливіше.
І тут виникає проблема: якщо потрібна інформація випала з контексту, модель не обов'язково зможе її відновити.
6. Memory — пам'ять моделі
А ось це вже інша історія.
Пам'ять — механізм збереження важливої інформації для використання в майбутніх розмовах.
Наприклад, система може зберігати:
- твої довгострокові навчальні цілі;
- важливі домовленості;
- особливості попереднього проєкту;
- твої вподобання щодо формату відповідей.
Тут важливо розрізняти речі:
Компонент - Що робить
Контекстне вікно - Утримує інформацію в поточній роботі
Memory - Зберігає вибрані відомості між розмовами
RAG - Знаходить потрібну інформацію у зовнішніх джерелах
І ще одна цікава деталь: пам'ять не обов'язково зберігає повну історію спілкування. Вона може містити лише відібрані факти та узагальнення.