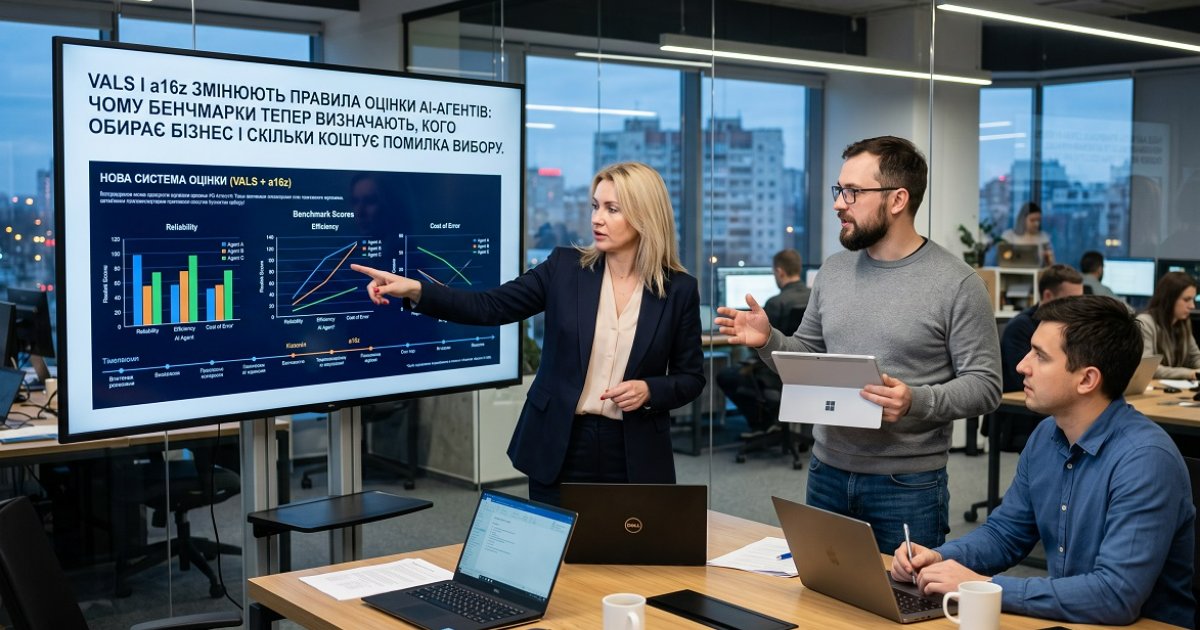
Ринок AI-агентів переповнений обіцянками. Кожен вендор запевняє, що його модель — найточніша, найшвидша, найнадійніша. Але як перевірити ці слова до того, як підписати контракт? Саме тут з'являється нова гравець — Vals AI — і разом із венчурним гігантом a16z вона переписує логіку того, як підприємства обирають AI-рішення.
Чому бенчмарки раптом стали вирішальними
Ще рік тому бенчмарки були академічною розвагою. Тепер вони — перший рядок у тендерній документації. Компанії більше не купують "AI взагалі": вони купують конкретну продуктивність на конкретних задачах.
Vals і a16z зробили ставку на те, що стандартизована оцінка стане інфраструктурою ринку — так само, як аудит став інфраструктурою фінансів. І схоже, ставка виграє.
Раніше вибір AI-платформи нагадував купівлю кота в мішку. Демо виглядало бездоганно, пілот проходив гладко, а потім у продакшені модель починала галюцинувати на крайових кейсах саме тоді, коли це найбільш боляче. Проблема не в тому, що моделі погані — проблема в тому, що їх порівнювали неправильно.
Стандартні публічні бенчмарки на кшталт MMLU чи HumanEval вимірюють загальні здібності. Але підприємство не наймає "загальний інтелект" — воно наймає агента, який має витягувати дані з контрактів, класифікувати заявки клієнтів або генерувати фінансові звіти. Різниця між "добре на бенчмарку" і "добре на моїй задачі" може коштувати мільйони.


