Що таке глибоке навчання (deep learning): як працюють нейронні мережі і де їх застосовують
Глибоке навчання (deep learning) — це напрям машинного навчання, у якому компʼютерні моделі вчаться на прикладах за допомогою багатошарових штучних нейронних мереж. Саме на цій технології працюють ChatGPT і голосові помічники, розпізнавання облич у смартфонах, машинний переклад і системи, що виявляють шахрайські транзакції в банках.
Масштаб технології добре ілюструє одна цифра: за даними OpenAI, ChatGPT щотижня користуються понад 1,2 млрд людей. Далі — як влаштовані глибокі нейронні мережі, чим вони відрізняються від класичного машинного навчання, які мають слабкі місця і чому в кібербезпеці ця технологія водночас захищає і атакує.
Головне
Глибоке навчання — частина машинного навчання, яке, своєю чергою, є частиною штучного інтелекту.
«Глибиною» називають кількість прихованих шарів нейронної мережі: їх можуть бути десятки і сотні.
Сучасні чат-боти побудовані на архітектурі «трансформер», описаній 2017 року; серед її авторів — уродженець України Ілля Полосухін.
Головні обмеження — потреба у величезних обсягах даних і обчислень, непрозорість рішень і переконливо сформульовані помилки.
У кібербезпеці глибоке навчання допомагає ловити фішинг і шахрайство, але ним же користуються автори дипфейків і автоматизованих атак.
Що таке глибоке навчання простими словами
Глибоке навчання — це спосіб навчити компʼютер розпізнавати закономірності не за заздалегідь прописаними правилами, а на великій кількості прикладів. Модель отримує тисячі чи мільйони зображень, текстів або аудіозаписів, порівнює свої відповіді з правильними і поступово коригує внутрішні налаштування, доки помилок не стане якомога менше.
Принцип нагадує те, як дитина вчиться впізнавати котів: ніхто не дає їй формального визначення, вона просто бачить багато котів і з часом сама виділяє характерні ознаки. Різниця в масштабі — нейронній мережі для цього потрібні не десятки, а сотні тисяч прикладів.
В українських текстах трапляються два терміни — «глибоке навчання» і «глибинне навчання». Вони означають одне й те саме; частіше вживають перший.
Штучний інтелект, машинне навчання і глибоке навчання: у чому різниця
Ці поняття вкладені одне в одне, як концентричні кола:
Штучний інтелект (ШІ) — найширша галузь: усе, що дає змогу машинам виконувати завдання, які зазвичай потребують людського інтелекту, від шахових програм до розпізнавання мовлення.
Машинне навчання — частина ШІ, у якій компʼютер не програмують покроково, а навчають на даних.
Глибоке навчання — частина машинного навчання, що використовує багатошарові нейронні мережі.
Головна практична відмінність — у тому, хто визначає ознаки. У класичному машинному навчанні інженер сам вирішує, на що модель має зважати. Глибока мережа знаходить ці ознаки самостійно.
Критерій Класичне машинне навчання Глибоке навчання Ознаки Інженер вручну визначає, на що зважати (наприклад, колір і форму плоду) Мережа сама виділяє ознаки із «сирих» даних Обсяг даних Часто вистачає тисяч прикладів Зазвичай потрібні сотні тисяч і мільйони прикладів Обладнання Звичайний процесор Графічні процесори (GPU) або спеціалізовані прискорювачі Пояснюваність Рішення відносно легко пояснити Модель часто працює як «чорна скринька» Типові завдання Прогноз продажів, кредитний скоринг, фільтри за правилами Розпізнавання зображень і мовлення, переклад, генерація тексту
Класичний приклад: щоб відрізнити на фото яблуко від апельсина, вистачить простої моделі, яка зважає на колір і форму. Розпізнавання рукописних цифр — зовсім інша задача: кожну цифру від 0 до 9 люди пишуть по-різному, з різним нахилом, товщиною ліній і пропорціями. Описати всі варіанти правилами майже неможливо, тож тут і стають у пригоді глибокі нейронні мережі.
Як працює нейронна мережа
Штучна нейронна мережа складається з вузлів — «нейронів», обʼєднаних у шари. Кожен нейрон виконує просту математичну операцію: отримує числа на вході, множить їх на вагові коефіцієнти, підсумовує і передає результат далі. Звʼязки між нейронами можна порівняти із синапсами в мозку: під час навчання вони посилюються або послаблюються. Саме таку аналогію наводить Шведська королівська академія наук у поясненні до Нобелівської премії з фізики 2024 року.
У кожній мережі є три типи шарів:
вхідний отримує дані — наприклад, значення пікселів зображення;
приховані поступово перетворюють ці дані, виділяючи дедалі складніші ознаки: спершу лінії й контури, потім форми, далі цілі обʼєкти;
вихідний видає результат — наприклад, імовірність того, що на фото кіт.
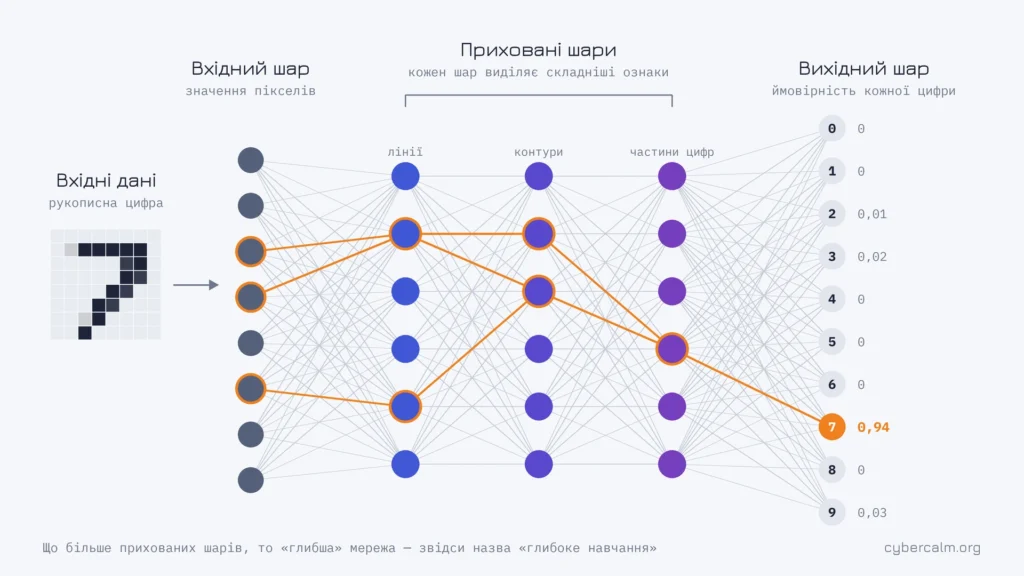
Спрощена схема глибокої нейронної мережі, що розпізнає рукописні цифри
Чому мережу називають «глибокою»
Слово «глибоке» стосується кількості прихованих шарів. Проста нейронна мережа може мати один-два таких шари, а глибокі мережі — десятки і навіть сотні. Що більше шарів, то складніші закономірності здатна вловити модель, але то більше даних і обчислень потрібно для її навчання.
Як мережа вчиться
Навчання — це цикл, що повторюється мільйони разів:
Мережа отримує приклад і робить прогноз.
Функція втрат (loss function) оцінює, наскільки прогноз відрізняється від правильної відповіді.
Алгоритм зворотного поширення помилки (backpropagation) обчислює, як кожна вага вплинула на помилку.
Метод градієнтного спуску трохи змінює ваги так, щоб наступного разу помилка була меншою.
Коли навчання завершено, ваги фіксують, і модель може обробляти нові дані, яких раніше не бачила. Цей етап називають інференсом (inference) — саме він відбувається щоразу, коли хтось ставить запитання чат-боту.
Основні типи глибоких нейронних мереж
Універсальної архітектури не існує: різні типи мереж краще пристосовані до різних завдань.
Згорткові нейронні мережі (CNN)
Основний інструмент компʼютерного зору. Перші шари таких мереж працюють як набір фільтрів, що «ковзають» зображенням і виділяють характерні елементи — краї, текстури, плями кольору. CNN застосовують у розпізнаванні облич, аналізі медичних знімків, системах допомоги водієві.
Рекурентні нейронні мережі (RNN) і LSTM
Призначені для послідовних даних — тексту, мовлення, часових рядів. Рекурентна мережа обробляє елементи по черзі і передає свій внутрішній стан від кроку до кроку, тож має своєрідну памʼять про попередні дані. Удосконалений різновид — мережі з довгою короткочасною памʼяттю (LSTM) — краще утримує звʼязки між віддаленими елементами послідовності. Їх використовують, зокрема, в антифрод-системах: модель аналізує ланцюжок транзакцій і позначає ті, що вибиваються з типової поведінки клієнта.
Генеративні змагальні мережі (GAN)
Складаються з двох мереж, які змагаються між собою: генератор створює синтетичні дані (наприклад, фото обличчя), а дискримінатор намагається відрізнити підробку від справжнього. У цьому змаганні генератор стає дедалі вправнішим. Саме на GAN зʼявилися перші дипфейки.
Трансформери
Архітектура, яка змінила всю галузь. Її описали у статті «Attention Is All You Need» 2017 року, яку підготувала група дослідників Google. Ключова ідея — механізм уваги (attention): замість читати текст слово за словом, як RNN, трансформер одразу «бачить» усю послідовність і зважує, які її частини найважливіші для кожного слова. Це дало змогу ефективно розпаралелювати навчання на великій кількості прискорювачів.
Серед восьми авторів статті — Ілля Полосухін, родом з України. Згодом він став співзасновником блокчейн-платформи NEAR.
На трансформерах побудовані майже всі сучасні великі мовні моделі (LLM): GPT від OpenAI, Gemini від Google, Claude від Anthropic, відкриті Llama і Gemma. Літера T в абревіатурі GPT (Generative Pre-trained Transformer) якраз і означає трансформер.
Дифузійні моделі
На них працює багато сучасних генераторів зображень і відео. Модель учиться поступово прибирати «шум» із зображення, а потім створює нову картинку з випадкового шуму, керуючись текстовим описом. Саме дифузійні моделі зробили синтетичні фото і відео настільки реалістичними, що їх дедалі важче відрізнити від справжніх.
Ключові віхи глибокого навчання
1980-ті. Джон Гопфілд і Джеффрі Гінтон, спираючись на методи фізики, закладають основи навчання штучних нейронних мереж.
Дослідники Google представляють архітектуру «трансформер».
Гінтон, Йошуа Бенджіо і Ян Лекун отримують премію Тюрінга — найпрестижнішу нагороду в інформатиці — за прориви, що зробили глибокі нейронні мережі ключовим компонентом обчислень.
Модель AlphaFold2 від Google DeepMind навчилася передбачати тривимірну структуру білків.
Кінець 2022. Запуск ChatGPT робить глибоке навчання масовою технологією.
Гопфілд і Гінтон отримують Нобелівську премію з фізики «за фундаментальні відкриття та винаходи, що уможливлюють машинне навчання зі штучними нейронними мережами». Автори AlphaFold Деміс Гассабіс і Джон Джампер розділяють Нобелівську премію з хімії.
OpenAI розгортає GPT-6 для всіх користувачів ChatGPT.
Де глибоке навчання застосовують сьогодні
Чат-боти і великі мовні моделі
ChatGPT, Gemini, Claude і Microsoft Copilot — це великі мовні моделі, навчені на величезних масивах тексту передбачати наступне слово. Покоління змінюються швидко: у вересні 2026 року OpenAI представила перші моделі GPT-6 для платних тарифів, а в жовтні почала розгортати GPT-6 для всіх користувачів, зокрема безкоштовних.
Кількість параметрів своїх флагманських моделей компанії здебільшого не розкривають. Тож цифри на кшталт «трильйон параметрів у GPT-4», які кочують інтернетом, — це оцінки сторонніх аналітиків, а не офіційні дані.
В Україні Мінцифри разом із «Київстаром» створює національну мовну модель «Сяйво». Її основою обрали відкрите сімейство моделей Gemma від Google, яке донавчають на україномовних даних. Назву обрали голосуванням у «Дії» наприкінці березня 2026 року. Відкрите бета-тестування планували на кінець весни, але строки перенесли.
Читайте такожПошукові системи зі штучним інтелектом: які обрати і як не потрапити в пастку
Голосові помічники
Siri, Alexa і Gemini використовують глибоке навчання двічі: щоб перетворити мовлення на текст і щоб зрозуміти, чого від них хочуть. З вересня 2026 року Google остаточно замінює Google Assistant на Gemini на Android-смартфонах — класичного голосового помічника витісняє мовна модель.
Смартфони і камери
Розблокування за обличчям, нічний режим камери, розмиття фону на портретах, автоматичне сортування фото в галереї — усе це завдання для нейронних мереж. Дедалі більше з них виконується безпосередньо на пристрої завдяки нейронним процесорам (NPU), без передавання даних у хмару.
Наука і медицина
Нейронні мережі аналізують рентгенівські знімки, МРТ і фото сітківки, допомагаючи лікарям помічати ознаки хвороб. Найгучніший науковий результат — AlphaFold: за даними Google DeepMind, її прогнозами структури білків, викладеними у відкритий доступ, користуються понад 2 млн дослідників зі 190 країн.
Безпілотні автомобілі
Автомобіль з автопілотом збирає дані з камер, радарів і лідарів, а нейронні мережі розпізнають у цьому потоці світлофори, розмітку, пішоходів та інші машини і допомагають вирішити, що робити далі: пригальмувати, зупинитися чи продовжити рух.
Фінанси
Банки і платіжні системи використовують глибоке навчання, щоб у реальному часі оцінювати ризик кожної операції: незвична сума, нова країна, підозріле поєднання дій у застосунку. Транзакцію, що вибивається з профілю клієнта, система може заблокувати або передати на перевірку людині.
Глибоке навчання в кібербезпеці: захист і загроза
Для кібербезпеки нейронні мережі — інструмент подвійного призначення. Ті самі моделі, що допомагають захисникам, потрапляють і до рук зловмисників.
Як нейронні мережі захищають
Фільтри спаму і фішингу аналізують не лише ключові слова, а й структуру листа, посилання і поведінку відправника.
Антивіруси і EDR-системи розпізнають шкідливе ПЗ за поведінкою, а не тільки за відомими сигнатурами, — так вдається ловити нові, ще не описані загрози.
Антифрод-системи банків блокують підозрілі транзакції за лічені мілісекунди.
ШІ-моделі дедалі частіше знаходять вразливості в коді — як нещодавні критичні помилки в PHP, через які урядові сайти в Європі довелося відключити.
Як ними користуються зловмисники
Дипфейки — підроблені відео і голос — використовують для шахрайства, зокрема під час відеодзвінків від імені керівників чи родичів.
Генеративні моделі пишуть переконливі фішингові листи без граматичних помилок, якими раніше видавали себе шахраї.
Боти на основі ШІ автоматизують атаки і генерують дедалі більшу частку інтернет-трафіку.
Атаки на самі моделі
Нейронні мережі мають і власні вразливості:
Змагальні приклади (adversarial examples) — ледь помітні зміни у зображенні чи звуці, через які модель помиляється: наприклад, не впізнає дорожній знак.
Отруєння даних (data poisoning) — підкидання шкідливих прикладів у навчальну вибірку, щоб модель засвоїла хибну поведінку.
Інʼєкції промптів (prompt injection) — приховані інструкції в листі, документі чи на вебсторінці, які змушують ШІ-асистента діяти всупереч інтересам користувача.
Тому відповіді і дії ШІ-асистентів, особливо ті, що стосуються грошей, паролів чи персональних даних, варто перевіряти так само ретельно, як роботу новачка-стажиста.
Недоліки й обмеження глибокого навчання
Голод до даних. Якісна модель потребує величезних і ретельно підготовлених наборів даних, а помилки та упередження в цих даних переходять у модель.
Вартість. За оцінкою дослідницької організації Epoch AI, вартість фінального навчання найпотужніших моделей з 2016 року зростала приблизно в 2,4 раза щороку. Якщо тенденція збережеться, найбільші навчальні запуски вже до 2027 року коштуватимуть понад мільярд доларів — такі витрати під силу лише небагатьом компаніям.
Енергоспоживання. Навчання моделі Gemini Ultra, за тією самою оцінкою Epoch AI, потребувало близько 35 мегаватів електричної потужності.
«Чорна скринька». Навіть розробники не завжди можуть пояснити, чому модель ухвалила те чи інше рішення. Для медицини, кредитування чи правосуддя це серйозна проблема.
Галюцинації. Мовні моделі можуть вигадувати факти, посилання і цитати та подавати їх упевненим тоном.
Технічні складнощі. Перенавчання (overfitting), коли модель «завчає» навчальні дані разом із шумом і гірше працює на нових; проблема зникаючого і вибухового градієнта; тривалий підбір гіперпараметрів — швидкості навчання, розміру пакета (batch size) тощо.
Коли варто використовувати глибоке навчання
Глибоке навчання виправдане, коли даних багато, вони переважно неструктуровані (зображення, звук, відео, вільний текст), а закономірності надто складні для ручних правил. Якщо ж даних мало, вони табличні, а рішення потрібно пояснювати, часто краще працюють простіші методи машинного навчання: вони дешевші, швидші і прозоріші.
Скільки часу триває навчання моделі
Від кількох хвилин до кількох місяців — залежно від розміру мережі, обсягу даних і обладнання. Невелику модель для розпізнавання рукописних цифр можна натренувати на звичайному ноутбуці за лічені хвилини. Базовий трансформер 2017 року автори навчали 3,5 доби на восьми GPU. Сучасні флагманські LLM тренують тижнями і місяцями у великих дата-центрах на тисячах прискорювачів.
Розрізняють також попереднє навчання (pre-training) — найдорожчий етап, коли модель вивчає мову і світ з нуля, — і донавчання (fine-tuning), коли готову модель адаптують під конкретне завдання. Донавчання потребує значно менше ресурсів; саме так створюють, наприклад, українську LLM на основі Gemma.
Як почати вивчати глибоке навчання
Для старту не потрібні потужна відеокарта і науковий ступінь — достатньо базової підготовки і регулярної практики:
Python — основна мова галузі. Базового синтаксису вистачить, щоб запускати перші приклади.
Математичний мінімум — лінійна алгебра (вектори, матриці), похідні та основи теорії ймовірностей. Розуміння поглиблюється вже на практиці.
Фреймворки — PyTorch і TensorFlow з високорівневим інтерфейсом Keras, два найпоширеніші інструменти.
Безкоштовні обчислення — Google Colab і Kaggle дають доступ до GPU просто в браузері, без встановлення програм.
Відкриті підручники і курси — інтерактивна книжка Dive into Deep Learning з прикладами коду і практичний курс ai.
Перший проєкт — класичне розпізнавання рукописних цифр на наборі даних MNIST, далі — класифікація власних фото чи аналіз тональності відгуків.
Два правила цифрової гігієни для початківців: не завантажувати в онлайн-сервіси для навчання моделей персональні дані, робочі документи чи чужі фото без дозволу; файли готових моделей брати лише з офіційних репозиторіїв і перевірених акаунтів, адже файл моделі з неперевіреного джерела може містити шкідливий код.
Часті запитання
Як правильно: глибоке чи глибинне навчання?
Обидва варіанти означають англійське deep learning і вживаються як синоніми. Частіше в українських текстах трапляється «глибоке навчання».
ChatGPT — це глибоке навчання?
Так. ChatGPT працює на великих мовних моделях сімейства GPT — це глибокі нейронні мережі архітектури «трансформер», навчені на величезних масивах тексту.
Чи потрібна потужна відеокарта, щоб користуватися нейромережами?
Щоб користуватися готовими сервісами — ні: обчислення відбуваються на серверах компанії. Щоб навчати власні моделі, бажано мати GPU або скористатися хмарними сервісами на кшталт Google Colab.
Чим штучна нейронна мережа відрізняється від людського мозку?
Вона лише натхненна будовою мозку і є спрощеною математичною моделлю. Нейронна мережа не мислить і не має свідомості: вона знаходить статистичні закономірності в даних і для навчання потребує незрівнянно більше прикладів, ніж людина.
Підсумок
Глибоке навчання з наукової ніші перетворилося на інфраструктуру повсякденного життя: воно перекладає, фотографує, відповідає на запитання, лікує і стереже банківські рахунки. Розуміння того, як влаштовані нейронні мережі і де їхні межі, допомагає користуватися ними з розумом — довіряти там, де технологія сильна, і перевіряти там, де вона схильна помилятися або може стати знаряддям шахраїв.
Ця стаття Що таке глибоке навчання (deep learning): як працюють нейронні мережі і де їх застосовують раніше була опублікована на сайті CyberCalm, її автор — Наталя Зарудня