Дослідники з Технологічного інституту Карлсруе виявили: звичайна модель машинного навчання, яка перетворює опади на річковий стік, недооцінила 97 % найвищих потоків у швейцарському тестовому наборі (топ 0,05 % рекорду). Версія тієї ж моделі, яка видає діапазон можливих значень замість одного числа, у 83 % цих випадків потрапила в зону 99-го процентиля.
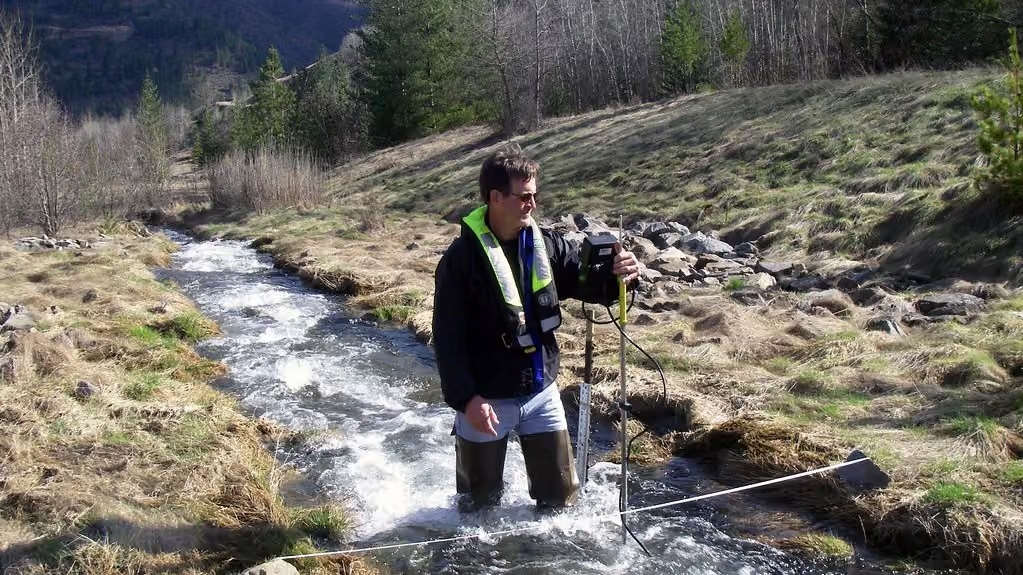
Йдеться про LSTM-мережі — нинішній стандарт для таких прогнозів. Проблема в тому, як їх навчають: коли модель просять одне число, вона видає значення ближче до середини можливих потоків після шторму. Реальний розподіл має довгий «хвіст» рідкісних, дуже великих подій — саме тих, що спричиняють повені.
Дослідження опубліковане 16 жовтня 2026 року в Hydrology and Earth System Sciences. Автори — Саніка Басте і Ральф Лоріц з KIT разом із колегами з Марбурзького університету та Міждисциплінарного трансформаційного університету Австрії — використали щоденні дані 196 швейцарських водозборів із відкритого набору CAMELS-CH.
Моделі з діапазоном також виявилися недосконалими. Тому команда створила агента підкріплювального навчання FRiCA. Він читає тижневі діапазони прогнозів і видає градуйоване попередження (від «повінь раз на два роки» до «раз на 300 років»). На історичних швейцарських даних FRiCA перевершив прості правила на основі одночислового прогнозу. В експлуатації його ще не застосовували.
Висновок авторів: обмеження в прогнозуванні екстремальних повеней може критися менше в конструкції мережі, а більше в тому, що містять навчальні дані. Стаття та набір даних відкриті.