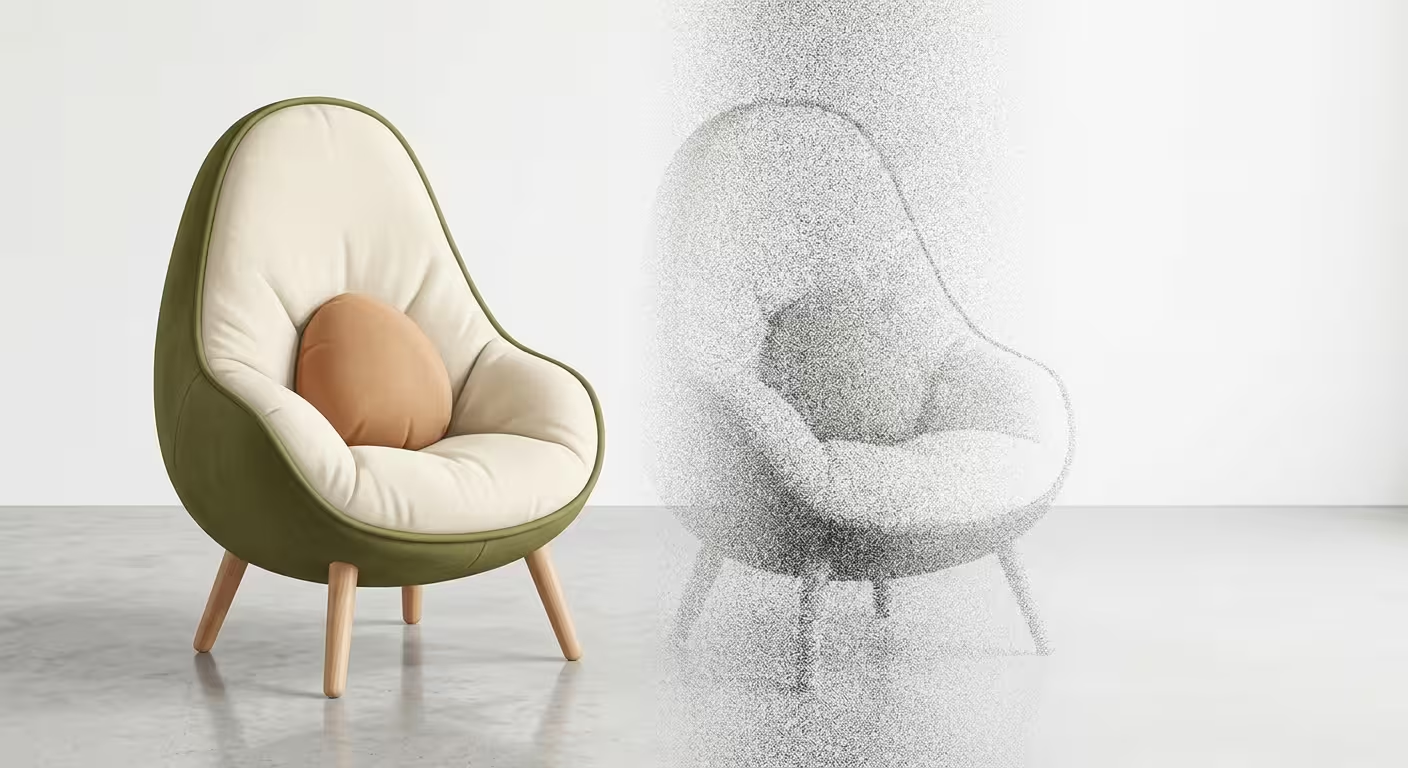
Як малює штучний інтелект: як працюють ШІ-генератори зображень і як користуватися ними безпечно
У січні 2021 року OpenAI показала нейромережу DALL·E, яка створювала зображення за текстовим описом: крісло у формі авокадо, редиску в балетній пачці, що вигулює собаку. Тоді це виглядало як дотепний лабораторний експеримент. Менш ніж за шість років генерація зображень стала звичайною функцією чат-ботів, графічних редакторів і навіть пошуку Google, а згенеровані картинки дедалі важче відрізнити від фотографій.
Як саме ШІ «малює», чому він досі помиляється, кому належать права на результат і як не отримати шкідливе ПЗ замість картинки — розбираємося в цьому матеріалі.
Головне
ШІ не малює пензлем і не склеює чужі картинки: модель вивчає закономірності на парах «зображення — опис» і крок за кроком перетворює випадковий шум на зображення, що відповідає запиту.
Провідні генератори 2026 року — ChatGPT Images 2.0 від OpenAI та Nano Banana 2 від Google — вбудовані в чат-боти й мають безкоштовний доступ із лімітами.
Фейкові «безкоштовні ШІ-генератори» з реклами в соцмережах — поширена приманка для викрадачів паролів: замість картинки користувач отримує шкідливе ПЗ.
В Україні згенеровані ШІ зображення не охороняються авторським правом — на них поширюється окреме право sui generis.
Відсутність водяного знака ШІ не доводить, що фото справжнє.
Від крісла-авокадо до генераторів, які «думають»
OpenAI представила DALL·E 5 січня 2021 року. За описом компанії, модель була версією GPT-3 з 12 мільярдами параметрів, навченою створювати зображення за текстовими описами на наборі пар «текст — зображення». Назву утворили з імен художника-сюрреаліста Сальвадора Далі та робота ВОЛЛ-І з мультфільму Pixar.
Розробники одразу визнавали обмеження: коли в запиті зʼявлялося більше обʼєктів, DALL·E починав плутати, який колір належить якому предмету, і частка вдалих результатів різко падала. Навіть перефразування запиту рівнозначними за змістом словами могло зіпсувати картинку.

Наступні покоління змінили саму технологію. DALL·E 2, Imagen від Google і Stable Diffusion належать до дифузійних моделей — про цей підхід нижче. У березні 2025 року OpenAI вбудувала генерацію зображень безпосередньо в мультимодальну модель GPT-4o і назвала новий підхід значно потужнішим за серію DALL·E 3.
21 квітня 2026 року компанія випустила ChatGPT Images 2.0 на моделі gpt-image-2. За словами представника OpenAI, нова версія значно краще виконує детальні інструкції, відтворює щільний текст і точніше розташовує обʼєкти, а також підтримує співвідношення сторін від 3:1 до 1:3. У режимі з «мисленням» ChatGPT може шукати інформацію в інтернеті та генерувати кілька зображень з одного запиту.
Google відповіла лінійкою Nano Banana: першу версію випустили в серпні 2025 року, Nano Banana Pro — у листопаді, а наприкінці лютого 2026 року зʼявилася Nano Banana 2 з технічною назвою Gemini 3.1 Flash Image. Вона стала моделлю за замовчуванням у застосунку Gemini, а також генерує зображення в пошуку Google через Lens і AI Mode.
Як ШІ «малює»: пояснення без формул
Генератор не зберігає колекцію готових картинок, з яких вирізає й склеює фрагменти. Під час навчання модель аналізує величезну кількість зображень із підписами й засвоює статистичні звʼязки: як зазвичай виглядає авокадо, чим акварель відрізняється від фотографії, з якого боку падає тінь у вечірньому світлі. Запит користувача модель перетворює на числове представлення й будує зображення, яке йому найкраще відповідає.
Дифузія: картинка, що проступає крізь шум
Робота дифузійної моделі нагадує проявлення фотографії. Генерація починається з випадкового «снігу», схожого на перешкоди на екрані старого телевізора. На кожному кроці модель прибирає частину шуму, щоразу звіряючись із текстовим запитом. Після десятків таких кроків із хаосу проступає крісло, кіт чи пейзаж.
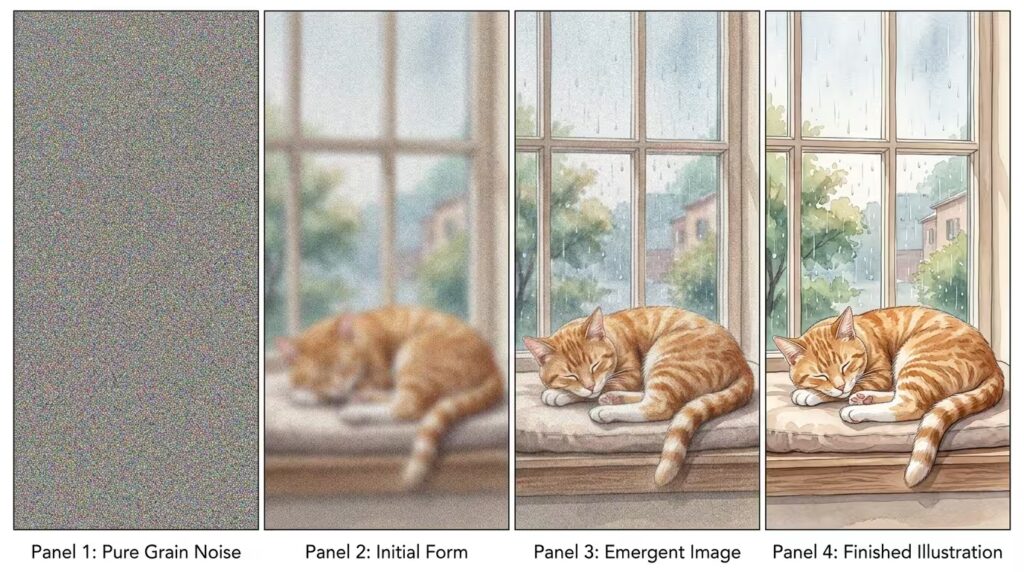
У науковій статті 2022 року дослідники описують цей процес як послідовне застосування «знешумлювальних» автокодувальників. Щоб заощадити обчислення, модель працює не з окремими пікселями, а зі стиснутим представленням зображення, а текст керує генерацією через механізм перехресної уваги (cross-attention).
Моделі, які «думають» перед малюванням
Новітні генератори виходять за межі класичної дифузії. Генерація зображень у ChatGPT вбудована безпосередньо в архітектуру мультимодальної моделі, тож може спиратися на все, що модель «знає» про світ. ChatGPT Images 2.0 OpenAI називає своєю першою моделлю зображень, здатною міркувати перед генерацією: вона планує композицію, шукає дані в інтернеті в реальному часі та перевіряє результат. Nano Banana 2, за даними Google, використовує базу знань Gemini, а також актуальну інформацію й зображення з вебпошуку, щоб точніше відтворювати конкретні обʼєкти.
Чому ШІ досі помиляється
Модель не розуміє світ так, як людина, — вона відтворює найімовірніші закономірності з навчальних даних. Звідси типові помилки: зайві пальці, неправильна кількість предметів, переплутані кольори й деталі, «текст», що лише нагадує літери.
Із текстом прогрес найпомітніший: Google заявляє про точне й розбірливе відтворення написів у Nano Banana 2, OpenAI — про якісний щільний текст у новій моделі. Втім, серед мов, для яких OpenAI окремо відзначила покращення, названо японську, корейську, китайську, гінді та бенгальську — української в цьому переліку немає. Тож написи кирилицею на згенерованих зображеннях варто уважно вичитувати.
Чи копіює ШІ чужі зображення
Коли DALL·E тільки зʼявився, критики питали, чи створює модель щось нове, чи просто перебирає побачене. У 2023 році це питання отримало експериментальну відповідь. Дослідники з Google, DeepMind, Принстонського університету, ETH Zurich і Каліфорнійського університету в Берклі показали, що дифузійні моделі запамʼятовують окремі зображення з навчальних даних і можуть відтворювати їх під час генерації. Із сучасних моделей вдалося видобути понад тисячу навчальних прикладів — від фотографій конкретних людей до логотипів, захищених як торговельні марки. Автори дійшли висновку, що дифузійні моделі значно гірше зберігають приватність навчальних даних, ніж попередні генеративні моделі.
Тому частина компаній робить ставку на «чисті» дані. Adobe стверджує, що навчає моделі Firefly лише на ліцензованому контенті, зокрема з фотобанку Adobe Stock, і на творах, строк охорони яких минув, а авторам Adobe Stock виплачує компенсацію. Компанія також запевняє, що ніколи не навчала Firefly на контенті користувачів.
Кому належать права на згенероване зображення в Україні
З 1 січня 2023 року в Україні діє нова редакція Закону «Про авторське право і суміжні права». Згідно зі статтею 8, неоригінальні обʼєкти, згенеровані компʼютерною програмою, не охороняються авторським правом — на них поширюється право особливого роду (sui generis) за статтею 33. Строк дії такого права становить 25 років.
Субʼєктами цього права можуть бути особи, яким належать майнові права або ліцензійні повноваження щодо програми, яка згенерувала обʼєкт. На практиці багато залежить від умов користування конкретним сервісом, тож перед комерційним використанням згенерованих зображень варто уважно прочитати ліцензійну угоду.
Ризики безпеки, про які мовчать рекламні пости
Фальшиві генератори, що крадуть паролі
Популярність ШІ-генераторів активно використовують кіберзлочинці. У травні 2025 року компанія Morphisec описала кампанію, у якій зловмисники рекламували у Facebook «безкоштовні» ШІ-платформи для створення зображень, відео й логотипів. Сторінки видавали себе за легітимний сервіс Luma Dream Machine; одна з них мала майже 4 тисячі підписників і синю позначку верифікації, а рекламний допис набрав понад 62 тисячі переглядів.
Схема проста: користувач завантажує своє фото, сайт нібито його «обробляє» й пропонує завантажити архів із готовим відео. Усередині — файл Video Dream MachineAI.mp4.exe, тобто програма, замаскована під відео. Після запуску на компʼютер потрапляє інфостілер Noodlophile, який викрадає збережені в браузері облікові дані, файли cookie, дані криптогаманців і токени та пересилає їх зловмисникам через Telegram. У частині випадків разом із ним встановлювався троян віддаленого доступу XWorm.
Від таких схем захищають кілька простих правил:
Генерувати зображення лише на офіційних сайтах і в офіційних застосунках сервісів, переходячи туди напряму, а не через рекламу в соцмережах.
Памʼятати, що результат онлайн-генерації — це зображення або відео, але ніколи не програма. Файл .exe, .scr чи .msi в архіві з «картинкою» — ознака атаки.
Увімкнути в системі показ розширень файлів, щоб подвійне розширення на кшталт .mp4.exe одразу впадало в око.
Читайте такожЯк безпечно завантажувати файли з інтернету і перевіряти їх перед відкриттям
Що відбувається з фото, завантаженими в генератор
Будь-яке зображення, надіслане в онлайн-генератор, обробляється на серверах компанії-розробника. У ChatGPT розмови можуть використовуватися для навчання моделей OpenAI. Щоб це вимкнути, у налаштуваннях потрібно відкрити розділ Керування даними і деактивувати параметр «Допоможіть покращити модель для всіх» — після цього нові розмови не використовуватимуться для навчання. Для бізнес-тарифів Team, Enterprise та Edu компанія пропонує додаткові налаштування контролю даних.
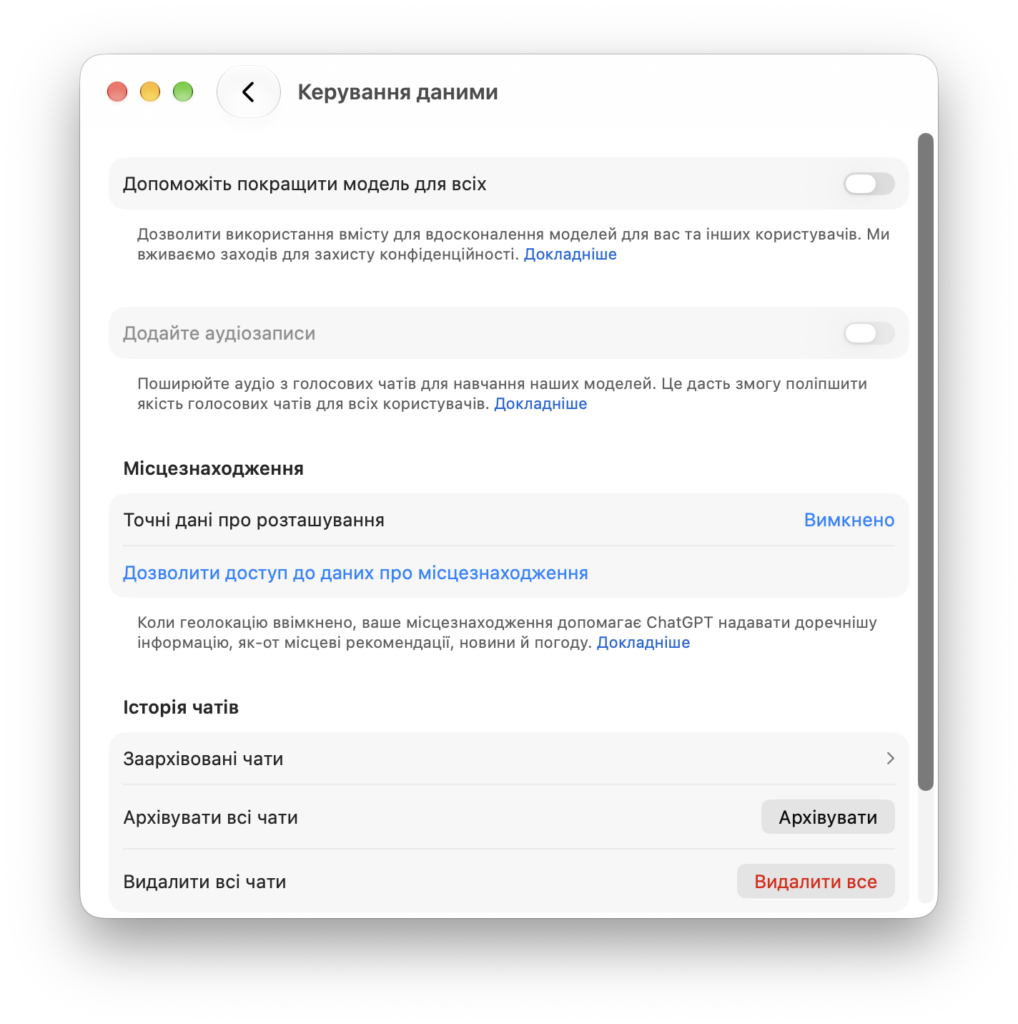
Навіть із вимкненим навчанням у генератор не варто завантажувати документи, фото дітей, знімки інших людей без їхньої згоди та робочі матеріали з конфіденційною інформацією.
Діпфейки: як перевірити, чи зображення згенероване
Що реалістичнішими стають генератори, то легше створити фальшиве «фото з місця подій» або компрометувальний знімок реальної людини. Для України, яка роками протидіє російській дезінформації, це не абстрактна загроза.
Найпростіший спосіб перевірити зображення — безкоштовний сервіс SynthID Detector, який Google відкрила для всіх на початку жовтня 2026 року. Він шукає в зображеннях, відео й аудіо невидимий водяний знак SynthID, яким позначають контент не лише моделі Google, а й партнери компанії — OpenAI, Nvidia та Kakao; підтримку Apple обіцяють додати згодом. Для входу потрібен акаунт Google, OpenAI або Apple, а інтерфейс поки що доступний лише англійською. За даними Google, SynthID уже містять понад 180 мільярдів зображень і відео.
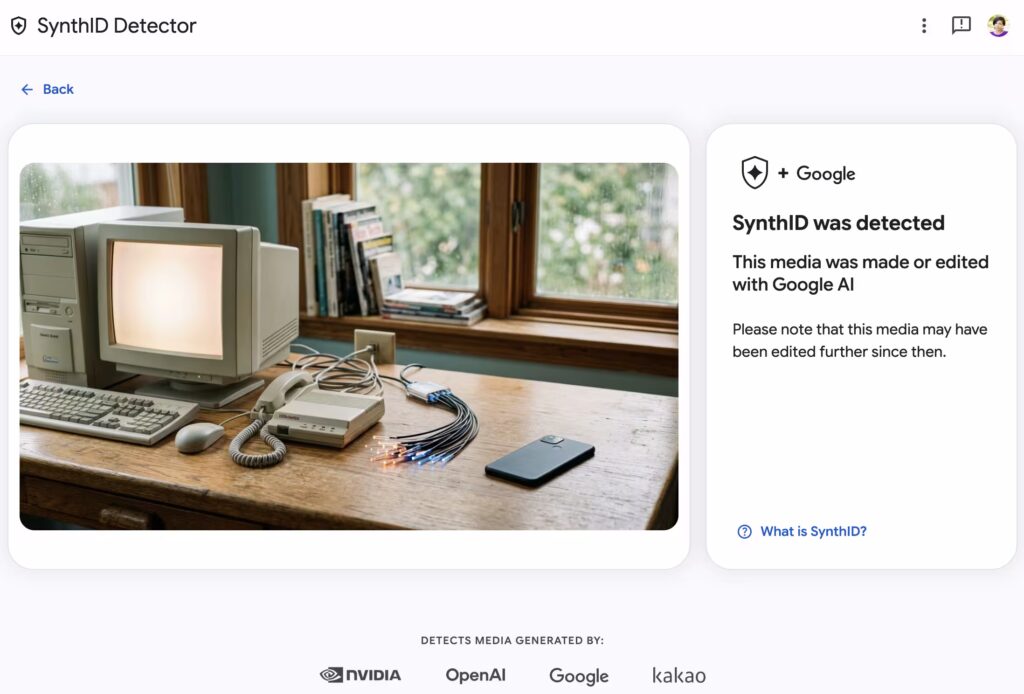
Та сама перевірка вбудована в пошук Google, браузер Chrome і застосунок Gemini: у ньому достатньо завантажити картинку й запитати, наприклад, «Is this AI-generated?». Зображення Nano Banana 2 також містять метадані стандарту C2PA Content Credentials, які фіксують походження файлу.
Водночас SynthID Detector не є універсальним детектором ШІ: він знаходить лише цей конкретний водяний знак. Зображення з генераторів, які SynthID не використовують, зокрема з відкритих моделей, запущених локально, сервіс не розпізнає. Тож відсутність позначки не доводить, що фото справжнє: варто перевіряти джерело публікації, контекст і наявність знімка в інших надійних медіа.
Читайте такожТеорія мертвого інтернету: як ШІ-агенти та боти перетворили конспірологію на статистику
Генератори з держави-агресора
Окремий ризик — сервіси російських компаній. Завантажені в них фото й запити опиняються під юрисдикцією держави-агресора, тож CyberCalm не рекомендує користуватися такими генераторами за жодних умов.
Де згенерувати зображення: основні сервіси 2026 року
Більшість популярних генераторів мають безкоштовний доступ із лімітами. Усі сервіси нижче розроблені компаніями зі США.
ChatGPT (OpenAI). Базова модель ChatGPT Images 2.0 доступна всім користувачам, а режим із «мисленням» і вищі ліміти — передплатникам Plus, Pro та Business. Зручний для поступового редагування зображення в діалозі.
Gemini (Google). Nano Banana 2 — модель за замовчуванням у застосунку Gemini; передплатники Google AI Pro та Ultra можуть перегенерувати зображення моделлю Nano Banana Pro. Згенеровані картинки позначаються SynthID.
Adobe Firefly. Функції Firefly вбудовані у Photoshop, Illustrator, Adobe Express та інші програми Adobe, а передплати включають щомісячні генеративні кредити. Орієнтований на комерційне використання.
Midjourney. Популярний серед ілюстраторів і дизайнерів сервіс із виразною «художньою» естетикою.
Окремий варіант — відкриті моделі на кшталт Stable Diffusion, які можна запустити на власному компʼютері з потужною відеокартою. Такий підхід потребує технічних навичок, зате зображення й запити не залишають пристрою.
Як скласти запит, щоб ШІ намалював потрібне
Якість результату значною мірою залежить від запиту — промпту. Ще 2021 року OpenAI зазначала, що успіх DALL·E залежить від формулювання. Сучасні моделі виконують інструкції значно точніше, але принцип не змінився:
Обʼєкт і деталі. Не просто «кіт», а «рудий кіт спить на підвіконні, за вікном дощ».
Стиль. Фотографія, акварель, олійний живопис, 3D-рендер, піксель-арт, лінійна ілюстрація.
Композиція й ракурс. Великий план, вигляд згори, широкий кадр, симетрія.
Світло й настрій. Мʼяке ранкове світло, контрове освітлення, тепла чи холодна гама.
Формат. Співвідношення сторін: 16:9 для обкладинки, 9:16 для сторіс, 1:1 для стрічки соцмереж.
Текст на зображенні. Напис — у лапках, із зазначенням мови; результат обовʼязково вичитати.
Уточнення в діалозі. Замість нового запиту — правки до готового: «зроби фон світлішим», «прибери людей із заднього плану».
Приклад запиту: «Акварельна ілюстрація: крісло у формі авокадо в затишній вітальні, мʼяке ранкове світло, вигляд збоку, формат 16:9».
Варто уникати запитів з іменами реальних людей і чужими торговельними марками: такі зображення можуть порушувати права третіх осіб, а в контексті дезінформації — завдати реальної шкоди.
ШІ-генератор — потужний інструмент для ілюстрацій, презентацій і творчих експериментів. Безпечним його роблять прості звички: офіційні сервіси, обережність із власними фото й критичне ставлення до кожного «надто реального» зображення в стрічці.
Ця стаття Як малює штучний інтелект: як працюють ШІ-генератори зображень і як користуватися ними безпечно раніше була опублікована на сайті CyberCalm, її автор — Побокін Максим