Майже в усіх статтях про аналіз та перетворення Фур’є мені траплялися лише уривки пояснень: десь детально розбирають FFT, але ні словом не згадують його використання в CV-фреймворках, десь чудово пояснюють Radix, але залишають поза увагою головне — навіщо ми взагалі застосовуємо Фур’є. У цій статті я зібрала все необхідне, щоб ви нарешті повністю розібралися з FFT та DFT.
Згортка - не просто множення
У більшості статтей згортку зводять до чогось на кшталт звичайного множення, яке з щіпкою магії лежить в основі CV та CNN-моделей. Таке пояснення ніби й має право на життя, але взагалі не дає розуміння, що з цим робити далі та як працює на low level. У мене серце крається бачити, що LLM ставлять на один рівень з математиками та що одна сторінка з навіть найновішою моделлю може замінити 400 сторінковий підручник. Виникає ілюзія «простої математики», за якою втрачається розуміння самого фундаменту та основи всіх технологій — математичного базису.
Найпрекрасніше та найгеніальніше пояснення того, навіщо сучасній інженерії взагалі потрібна згортка (і не лише у сфері CV), можна почитати ось тут — далі я коротко відтворю його суть.
Головне — усвідомити, що згортка — це не просто множення. Це принципово нова сутність, утворена з двох інших форм, двох функцій.
Інтуїтивне розуміння
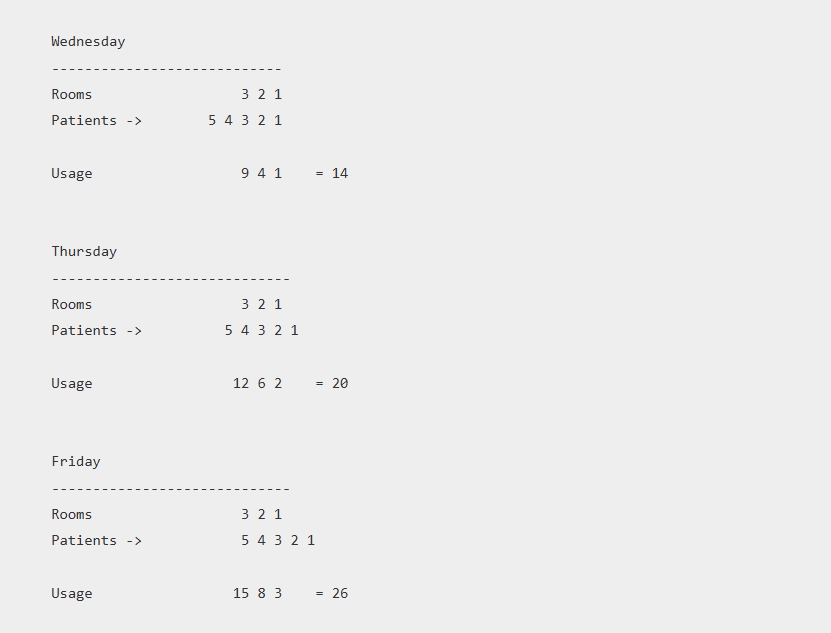
Уявіть себе у кріслі лікаря: у вас є 5 різних пацієнтів і 3-денний курс лікування для кожного. Колега просить вас порахувати, скільки всього доз знадобиться на ці 5 днів.
Ви відчуваєте, що з кожним днем витрата ліків буде акумулюватися. Пацієнти прибувають щодня (1 у понеділок, 2 у вівторок, 3 у середу, 4 у четвер і 5 у п’ятницю). У будь-який конкретний день у вашій приймальні — мікс із новоприбулих, пацієнтів другого дня та тих, хто вже завершує курс. Якщо вести облік по кожному пацієнту окремо, підрахунок щоденної норми швидко перетвориться на хаос:
Сьогоднішні новоприбулі отримують ліки 1-го дня (3 дози).
Вчорашні пацієнти отримують ліки 2-го дня (2 дози).
Позавчорашні пацієнти отримують ліки 3-го дня (1 доза).
Помітили закономірність? Ви зіставляєте план лікування з історією прибуття пацієнтів у зворотному хронологічному порядку. Тепер можна просто взяти цей розвернутий список і «зсувати» його вздовж списку пацієнтів, щоб отримати сумарну накопичену дозу.
Математична згортка
Я використала слово «акумулювати» у прикладі з лікарем не просто для красного слівця. Математична операція, яка дозволяє обчислити об'єм, суму чи накопичення значення функції — це інтегрування. І саме його ви бачите у формулі згортки.
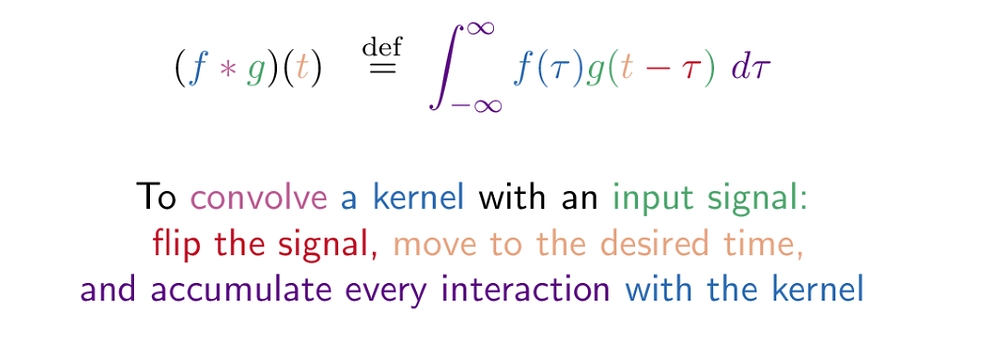
f(x) — це ваш список пацієнтів.
g(-x+t) — це список вхідних даних (розвернений та зсунутий до потрібного дня).
g(x+t) показує, як змінюється дозування з часом, а після розвороту (який потрібен, щоб «протягнути» його вздовж списку пацієнтів) ми й отримуємо g(-x+t).
Як не плутати згортку зі звичайним множенням:
Результат згортки — це нова функція, яка дає сумарні витрати для будь-якого дня («Якими були загальні витрати в день t?»). Ми можемо побудувати графік згортки в часі, щоб бачити динаміку по днях.
Сума Рімана vs Згортка: сума Рімана рахує об'єм (чи площу) однієї фігури, розділяючи на менші квадрати, тоді як згортка обчислює об'єм нової, «змішаної» форми, утвореної двома функціями.
Вона описує, як форма однієї функції видозмінюється під впливом іншої.
Хитромудре множення у звичайному світі — це звичайнісіньке множення у «хитромудрому» (частотному) світі.
Згортка — це значно ширше поняття, ніж множення. Вона скоріше нагадує цілий механізм чи рушій.
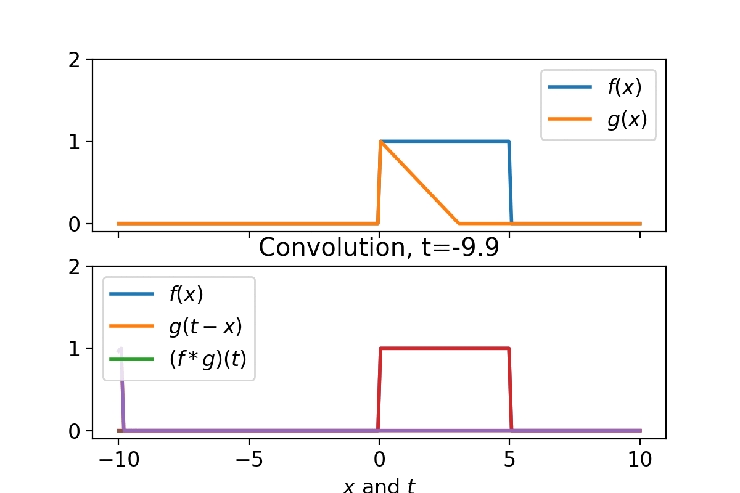
Звичайне множення дає просто одну масштабовану копію вхідних даних. Згортка ж створює безліч накладених копій, що розгортаються за заданим вами шаблоном.
Графічно це виглядає ось так:
Властивості, на яких усе тримається
Саме на цих властивостях розгортається вся сфера Computer Vision. Особливо на другій — адже саме завдяки їй у згортці застосовують дискретне перетворення Фур’є (DFT), а не іншу трансформацію.
1. Згортка комутативна (f * g = g * f)
Тут діє той самий принцип, що й у звичайній теорії множення. Якщо згадати приклад зі зсуванням списку ліків вздовж списку пацієнтів, це може здатися не зовсім інтуїтивним (яка різниця, що по чому «ковзає»?). Але «під капотом» операції зсуву лежить звичайне множення. А оскільки внутрішня операція є комутативною, то й зовнішня операція (згортка) переймає цю властивість.
2. Інтеграл від згортки двох функцій дорівнює добутку окремих інтегралів
Якщо подивитися на згортку з точки зору функцій, підсумкове накопичене значення шукають саме через інтегрування. Унікальність згортки в тому, що інтеграл від згортки двох функцій дає такий самий результат, як і просте множення двох окремих інтегралів від кожної з них. Для звичайного множення цей фокус не працює (інтеграл добутку не дорівнює добутку інтегралів), а от для згортки — працює ідеально.
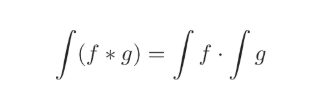
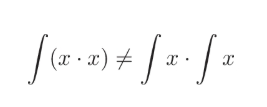
Сподіваюся, таке пояснення розклало все по поличках. Якщо ж хочеться зануритися ще глибше — ось чудовий доказ.
Теорема про згортку (Convolution Theorem)
Ця теорема спирається саме на другу властивість згортки. Для мене справжнім моментом осяяння (тим самим «ага!»-моментом) стала фраза з BetterExplained:
Хитромудре множення у звичайному світі — це звичайнісіньке множення у «хитромудрому» світі.
Суть теореми полягає в тому, що згортка дорівнює звичайному множенню у області сигналів (області Фур’є).
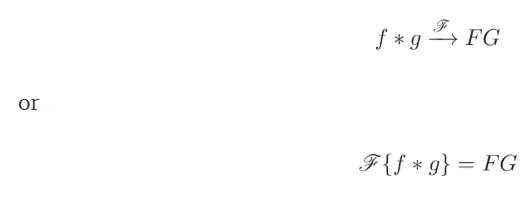
Чому це так працює? Якщо застосувати перетворення Фур’є до прикладу з лікарнею, воно розкладе все на чіткі пари «пацієнт × дозування» — фактично відтворивши той самий ефект, який ми отримували під час «зсування» списків.
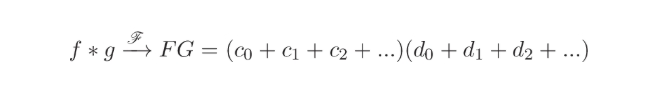
Про саме перетворення Фур’є я детальніше розповім у наступному розділі.
Тепер, коли ми розібралися з базовими принципами згортки, час перейти до головної теми — перетворення Фур’є.
Триєдинство Фур’є
Сфера аналізу Фур’є тримається на трьох стовпах: рядах Фур’є, власне аналізі Фур’є та перетворенні Фур’є (безперервному FT та дискретному DFT):
Аналіз Фур’є (загальна дисципліна): Усе почалося з дослідження фізичних явищ — таких як коливання струни чи поширення тепла. Фундаментальна ідея, запропонована Жозефом Фур’є, полягає в тому, що «довільну» функцію можна подати у вигляді суми базових тригонометричних хвиль.
Ряди Фур’є (для періодичних функцій): Першопочатковий інструмент, який застосовують до періодичних функцій або функцій, заданих на обмеженому інтервалі (наприклад, на колі). Він виражає функцію через дискретну послідовність чисел — коефіцієнти Фур’є. Математика тут спирається на нескінченні суми за цілими числами.
Перетворення Фур’є (для неперіодичних функцій): Його розробили як аналогічну теорію для роботи з неперіодичними функціями, визначеними на всій числовій прямій. Воно виступає безперервною версією коефіцієнтів Фур’є: замість дискретних сум за цілими числами тут використовується безперервна змінна частоти, а розрахунок іде через інтеграли.
Дискретне перетворення Фур’є (DFT): Підрозділ перетворення для дискретних об'єктів. Його застосовують до дискретних скінченних даних (наприклад, матриць пікселів у зображеннях). Саме на DFT спирається більшість практичних застосувань у Computer Vision.
Я коротко поясню суть аналізу Фур’є, щоб дати базове розуміння того, що це таке і навіщо воно потрібне, а далі ми детальніше зануримося саме в дискретне перетворення Фур’є.
Основи аналізу Фур’є
Я щиро рекомендую ці книги, якщо ви хочете на повну відчути всю потужність концепцій Фур’є:
«Fourier Analysis» — Stein, Princeton
«The Fourier Transform and its Applications» (конспекти лекцій, чудово підійде для новачків)
Головна мета аналізу Фур’є — зрозуміти, пояснити, трансформувати та знайти частоту або групу частот. Уявіть, що у вас є радіоприймач (тип зараз неважливий), і ви хочете дізнатися, які частоти там присутні, які з них стабільні та який їхній діапазон. Ви подаєте сигнал на вхід перетворення Фур’є, а на виході отримуєте список усіх частот та їхніх характеристик. Якщо коротко, воно розкладає складний сигнал на набір базових частот.
Перетворення Фур’є — це аналог рядів Фур’є, але для неперіодичних безперервних функцій. Воно переводить функцію у безперервний континуум частот Е є R.
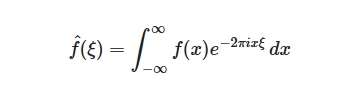
Число Ейлера — це фундаментальна річ у сфері Фур’є, адже воно об’єднує в собі синус (несиметричну хвилю) та косинус (симетричну хвилю). Це робить обчислення набагато компактнішими, бо не потрібно розкладати сигнал та зіставляти його з косинусом і синусом окремо.
Священний ґрааль: уявна одиниця i, число Ейлера та тотожність Ейлера
Як узагалі математично описати зображення? Як матрицю? Чи як послідовність змін осей? Можна, звісно, й не замислюватися над цим — але тільки не тут.
Мені подобається аналогія з монетою. Як у монети є дві сторони, так і в зображення їх дві: матричне подання та функціональне подання.
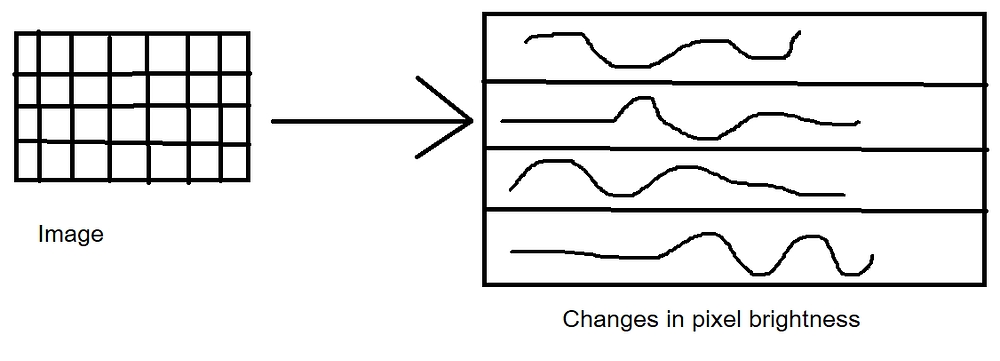
Матриця складається з рядків і стовпців, де кожен елемент відповідає за яскравість конкретного пікселя. Якщо взяти яскравість уздовж одного рядка й побудувати графік, ми отримаємо хвилясту функцію з підйомами та спадами.
Але як це описати мовою математики? Підйоми й спади дуже схожі на ділянки синуса та косинуса, а рух уперед описується експонентою e. Круто, але як змусити її обертатися? І ось тут на сцену виходить уявна одиниця i, яка додає ефект обертання: без неї функція просто нескінченно зростала б.
Формула Ейлера елегантно об’єднує все це в одне ціле — синус, косинус, число e та уявну одиницю i. Вона позбавляє тон громіздких і важких обчислень.
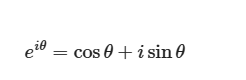
Тотожність Ейлера описує окремий випадок із поворотом на півкола (pi) — підставляючи замість довільного кута саме pi:
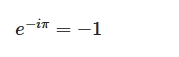
У класичному вигляді перетворення Фур’є спирається лише на формулу Ейлера, але оптимізовані алгоритми (як-от алгоритм Кулі — Тьюкі) додатково використовують і тотожність Ейлера для прискорення обчислень. Детальніше про це — у наступних розділах.
(Я додаватиму скріншоти з нотатника, бо Друкарня поки не має LaTeX)
Пошук та перевірка частот за допомогою перетворення Фур’є
Попри свою назву, перетворення Фур’є вміє не лише трансформувати сигнал, а й шукати та виявляти конкретні частоти.
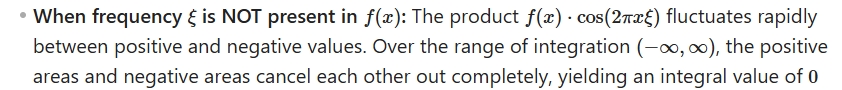
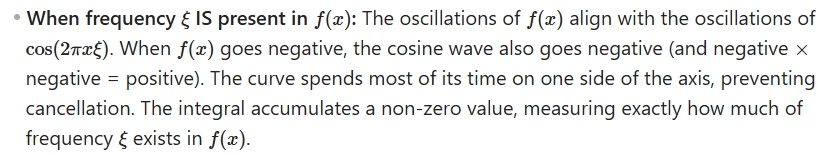
Головне завдання перетворення Фур’є — розкласти складову сутність на набір базових компонентів. У класичному FT такими компонентами є саме частоти. Зрозуміти, чи присутня в сигналі потрібна частота, можна за допомогою «інтегральної дистиляції»: якщо частоти не збігаються, додатні та від’ємні площі взаємно нейтралізуються (дають нуль), а якщо збігаються — вони підсилюють одна одну й накопичують підсумкове значення.
Таким чином, інтеграл працює як своєрідний «локатор» базових компонентів:
Дискретне перетворення Фур’є (DFT) працює за тими ж принципами, але використовує дещо інший інструментарій. Пригадайте, що в основі інтеграла лежить сума Рімана — ми просто розбиваємо площу під кривою на безліч крихітних прямокутників. Коли їхня ширина прямує до нуля, сума цих прямокутників і дає нам площу під кривою, тобто інтеграл. DFT використовує той самий трюк: ми не можемо взяти інтеграл від зображення чи іншого дискретного об’єкта, але можемо знайти суму його окремих компонентів.
Як виявити потрібну частоту
Перетворення Фур’є дозволяє чітко перевірити, є конкретна частота в сигналі чи немає:
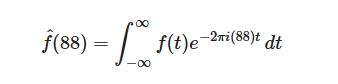
Цей інтеграл працює точно так само, як налаштування радіоприймача чітко на 88-му хвилю. Він відсікає абсолютно всі інші частоти в сигналі й видає на виході одне-єдине комплексне число.
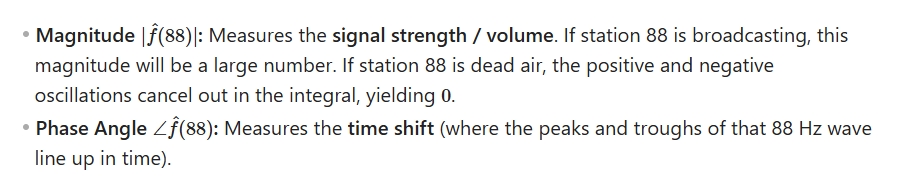
Амплітуда (модуль): вимірює силу або гучність сигналу. Якщо радіостанція 88 працює в ефірі, амплітуда буде високою. Якщо ж там мертва тиша (порожній ефір), додатні та від’ємні коливання в інтегралі повністю згашать одне одного, даючи в результаті 0.
Фазовий кут (фаза): вимірює часовий зсув (показує, де саме на часовій осі розташовані піки та западини цієї хвилі з частотою 88 Гц).
Дискретне перетворення Фур’є (DFT)
А тепер пірнаємо з головою в кролячу нору DFT: розберемо, як воно працює на папері та що насправді відбувається в оперативній пам’яті й процесорі (RAM/CPU). Коли я вперше взялася за вивчення DFT, воно взагалі не здавалося мені чимось захопливим. Але під час написання цієї статті я пережила десятки моментів осяяння (тих самих «ага!»-ефектів) — ця тема мене просто затягнула, і тепер я з упевненістю можу сказати, що справді розібралася з DFT. Сподіваюся, цей матеріал допоможе й вам: якщо досі DFT викликало острах, то після прочитання ви не лише зрозумієте суть, а й матимете власне бачення, як його елегантно реалізувати в коді.
Як я вже згадувала, DFT — це перетворення Фур’є для дискретних об’єктів. Тут для інтегралів вхід заборонений — у цьому світі править багаторівневе сумування. Основну увагу я зосереджу на DFT для зображень (зокрема 2D-матриць), але ті самі принципи чудово працюють і для інших сигналів — наприклад, у радіозв’язку чи мобільних мережах.
Оригінально я писала цю статтю англійською, оскільки всі матеріали по Фур’є, які читала, також написані англійською, до кожного скріншоту з мого записника я буду прикріпляти переклад.
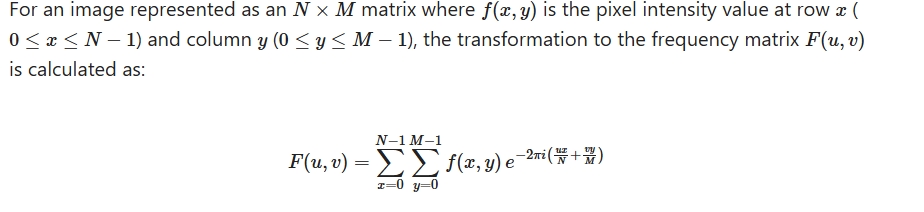
Спочатку ця формула може трохи налякати, але це ненадовго. Давайте розберемо, що означає кожен її елемент:
x, y: Просторові координати пікселя.
f(x, y): Інтенсивність пікселя (значення 0–255 або 0–1 після нормалізації).
u, v: Індекси просторової частоти— тобто кількість повних циклів хвилі на висоту та ширину зображення.
N, M: Висота та ширина зображення.
e(): Двовимірні дискретні комплексні експоненціальні базисні функції. Про них також далі.
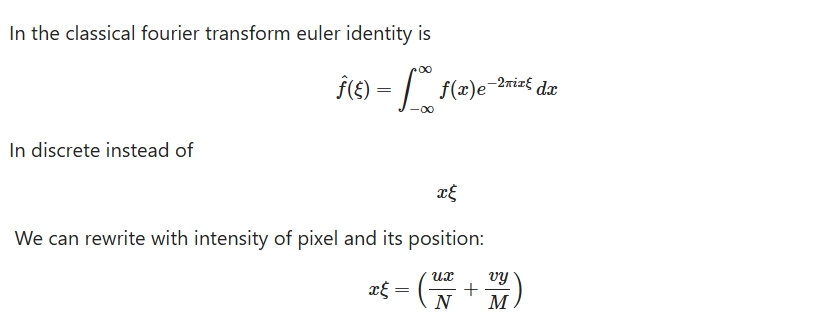
Якщо коротко: це подвійна сума добутку інтенсивності пікселя та експоненціальної базисної функції (яка по суті є формулою Ейлера). Зверніть увагу, що тут формула Ейлера має дещо інший вигляд: у класичному FT використовувалася частота, а тут роль частоти (того, що змінюється) відіграють просторові (spatial) частоти u та v (тобто кількість циклів на один вимір).
Як зображення перетворюється на частоти
Зображення має координати пікселів, їхню інтенсивність, а також ширину й висоту.
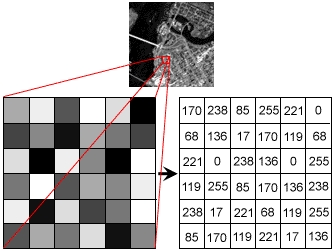
Якщо нанести інтенсивність пікселів точками на папері й з’єднати їх лінією, вийде свого роду функція (а якщо точніше — гістограма). Зображення складається не з одного, а з цілої безлічі таких наборів інтенсивності, кожен з яких можна зобразити у вигляді окремої функції.
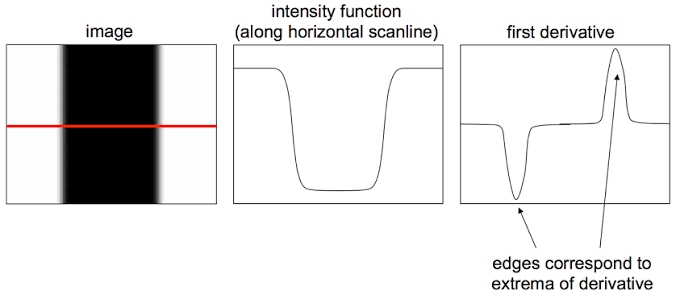
Рухаємося зліва направо: ви крокуєте по білих пікселях, і під ногами у вас значення 255 — це значення білого кольору. Ви йдете й йдете, як раптом опиняєтеся на пікселях із нулем. Оцей різкий обвал від 255 до 0 чудово видно на середньому малюнку: функція інтенсивності пікселів стрімко летить донизу, а разом із нею й перша похідна. Тепер ви знову стаєте на білі пікселі й бачите дзеркальну картину — цього разу функція рішуче йде вгору.
Як правильно зрозуміти компоненти u, v у DFT
Завдяки формулі Ейлера ми можемо розкласти DFT у набагато наочніший та зрозуміліший вигляд:
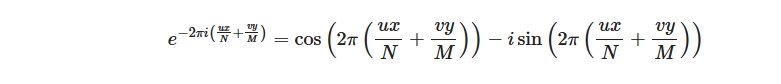
У одновимірному просторі (1D) синусоїда чи косинусоїда — це вектор чисел, які коливаються вгору й вниз. У 2D це вже матриця розміром N * M, де значення пікселів плавно хвилюються вздовж рядків та стовпчиків.
Щоб усе остаточно встало на свої місця, критично важливо осягнути роль і фізичний зміст кожного з компонентів:
Вертикальна частота (u): відповідає за те, скільки повних циклів хвилі пробігає від найверхнішого до найнижчого рядка.
Горизонтальна частота (v): відповідає за кількість повних циклів хвилі від крайнього лівого до крайнього правого стовпчика.
Орієнтація / кут нахилу: співвідношення u до v визначає діагональний кут утворених смуг. Наприклад, якщо u=0, а v=5, хвиля коливається виключно по горизонталі, створюючи вертикальні смуги. Якщо ж u=5 і v=5, хвиля коливатиметься строго по діагоналі.
Чому синус дружить з i, а косинус — ні?
Це одне з тих підступних запитань: здавалося б, жити було б набагато простіше, якби в обчисленнях можна було обійтися без уявної одиниці i, правда? Але не все так просто.
Синусоїди й косинусоїди забезпечують періодичність, але як бути з довільним зображенням (наприклад, у відтінках сірого)? Уявна одиниця i бере цю задачу на себе. Вона необхідна тому, що реальні просторові сигнали (зокрема й 2D-картинки) зазвичай несиметричні відносно рядків чи стовпчиків. i приєднується саме до синусоїдальної базисної функції, створюючи фазовий зсув у 90° відносно косинуса. Це дозволяє DFT однаково влучно вловлювати як симетричні (парні), так і антисиметричні (непарні) просторові зміни.
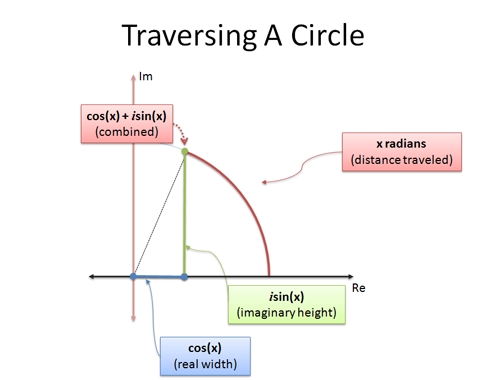
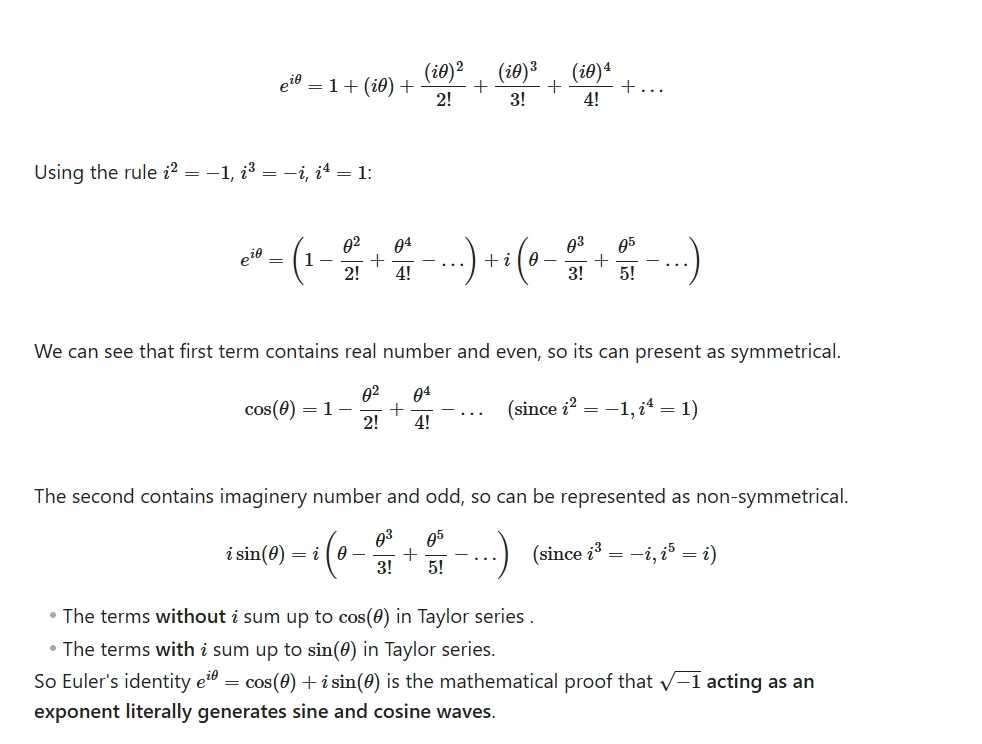
Завдяки формулі Ейлера косинусна частина у нас є дійсним числом, але чому ж синусна частина виявляється саме уявною? Усе це випливає з властивостей розкладу тотожності Ейлера в ряд Тейлора:
Пошук кореляції частот лише за допомогою матриці косинусів: DFT на колінках
Добре, але чим ми жертвуємо, якщо залишимо тільки матрицю косинусів? Здавалося б, без уявної одиниці i обсяг обчислень має скоротитися. Це виглядає як привабливий план «Б», але парадокс у тому, що саме завдяки i стає можливим колосальне алгоритмічне прискорення. Давайте подивимося, що станеться, якщо ми взагалі відмовимося від формули Ейлера.
Матрицю W називають Twiddle factor matrix - це розрахунок за формулою Ейлера для майже кожного пікселя.
Нехай маємо матрицю зображення f розміром N * M:
Генеруємо 2D-матрицю хвилі:

Виконуємо поелементне множення (element-wise multiplication):
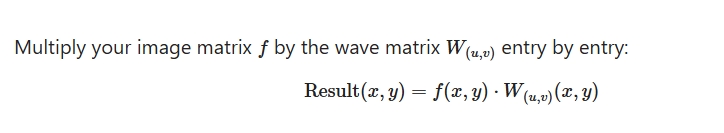
Сумуємо всі елементи матриці:
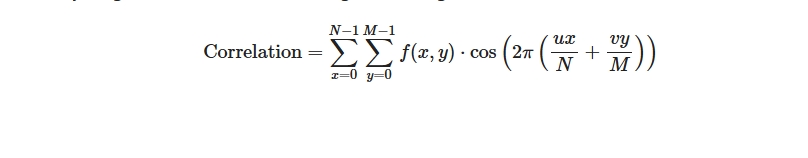
Якщо паттерн (структура) Є в сигналі: Яскраві пікселі зображення (f(x,y) > 0) синхронізуються з додатними смугами хвилі W{(u,v)} , що дає додатні добутки. Темні пікселі (f(x,y) < 0) потрапляють на від’ємні смуги — відтак множення двох від’ємних чисел знову дає додатний результат. Під час підсумовування всі ці значення накопичуються у велику загальну суму.
Якщо паттерна НЕМАЄ: Яскраві та темні пікселі потрапляють на додатні й від’ємні смуги W{(u,v)} хаотично. У результаті додатні та від’ємні добутки повністю взаємозгашуються при сумуванні матриці, даючи результат, близький до нуля.
Цей метод кореляції працює виключно з косинусною матрицею, тому здатен виявляти лише симетричні паттерни. Проте реальне зображення складається як із симетричних, так і з несиметричних елементів (яких більшість) — і всі несиметричні деталі при такому підході просто випаровуються - втрачається більша частина інформації.
Вирішуємо проблему симетричної кореляції за допомогою формули Ейлера
Формула Ейлера поєднує в собі симетричну косинусоїду та несиметричну синусоїду. Тож аби шукати не лише симетричні паттерни, а й несиметричні, нам потрібна матриця, що містить і косинусну, і синусну хвилі.
Завдяки формулі Ейлера ми можемо легко змінювати знак:
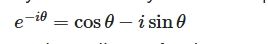
Замінивши суто косинусну матрицю на вираз із формулою Ейлера, ми приходимо до тієї самої формули:
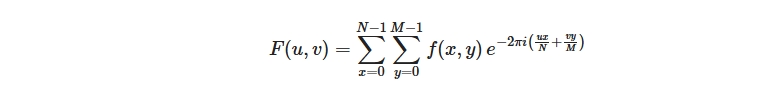
Двовимірну косинусну матрицю — для отримання дійсної частини (Real component) R(u, v).
Двовимірну синусну матрицю — для отримання уявної частини (Imaginary component) I(u, v).
У результаті ми можемо фіксувати як симетричні, так і несиметричні хвилі, але тепер усі отримані значення стають комплексними числами.
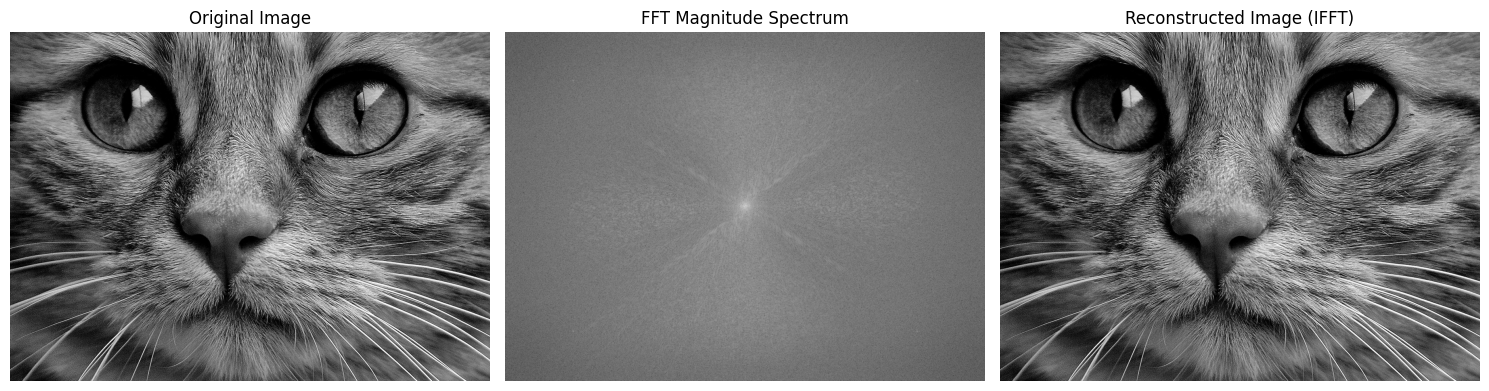
Запустивши таке поелементне множення матриць із подальшим підсумовуванням для кожної допустимої пари частот (u, v), ми перетворюємо початкову просторову матрицю пікселів на двовимірну матрицю частотного спектра. Вона наочно відображає, як зображення або просторовий паттерн поводиться на різних просторових частотах (зокрема при горизонтальних та вертикальних змінах). Кожен елемент цієї матриці є комплексним числом і містить у собі інформацію як про амплітуду, так і про фазу.
Матрицю частотного спектру доволі важко уявити та зрозуміти чому вона взагалі така, як є. Посередині значення середніх частот - далі від центру всіх інших. Ось тут наприклад вусики киці дуже сильно виділяються від мордочки, тому спектр має діагональні лінії.
Як комплексні числа обчислюються в RAM та CPU/GPU
Давайте коротко розберемо, як це працює в теорії, а потім подивимося, що насправді відбувається в оперативній пам’яті та процесорі (RAM/CPU).
Сучасні обчислювальні системи не вміють обробляти комплексні числа напряму так, як ми це робимо на папері в математичному аналізі. Комплексне число записується як z = a + bi, де a та b — це дійсні числа.
Тому в пам’яті комп’ютера воно представляється просто як структура або пара елементів z = {A, B}:
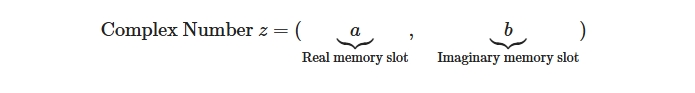
Найкращий спосіб зрозуміти — уявити уявний «слот» як своєрідний роутер: він видає -1, i та 1 залежно від степені i.
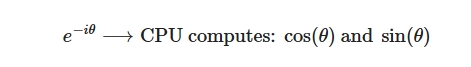
Для обчислення DFT сучасні фреймворки використовують формулу Ейлера, щоб розділити процес на дійсну та уявну частини:
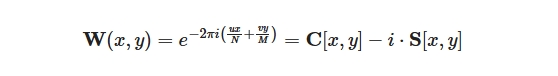
Косинусна матриця (дійсні значення):
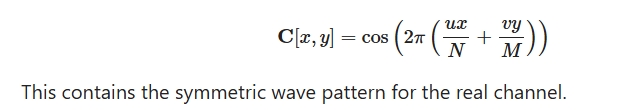
Синусна матриця (уявні значення):
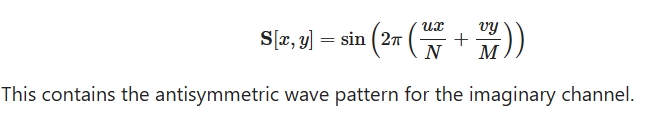
Комплексні числа в оперативній пам’яті (RAM)
Комп’ютер зберігає комплексне число z = a + bi максимально просто: він виділяє під нього два послідовні дійсні числа з плаваючою крапкою (float64/double), які лежать у пам’яті:
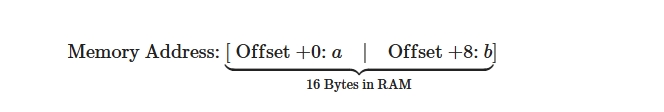
Зсув +0 (Offset +0): зберігає дійсну частину a.
Зсув +8 (Offset +8): зберігає уявну частину b.
Комплексі числа у процесорі (CPU)
Рівняння i^2 = -1 перетворюється на звичайну інструкцію віднімання (наш той самий «роутер»):
Коли ви множите два комплексні числа, алгебраїчне розкриття дужок виглядає так:
(a + bi)(c + di) = ac + bci + adi + bd * i² = (ac — bd) + (ad + bc)i
Під час компіляції цього коду для CPU або GPU компілятор розгортає уявну одиницю i у шість цілком реальних апаратних інструкцій над дійсними числами:
MUL: Обчислення a * c
MUL: Обчислення b*d
SUB: Обчислення ac - bd (саме в цьому відніманні i^2 = -1 матеріалізується фізично!)
MUL: Обчислення a *d
MUL: Обчислення b *c
ADD: Обчислення ad + bc
Експонента Ейлера в сучасних системах як звичайна тригонометрія
Коли інтерпритатор обчислює формулу Ейлера, процесор ніколи не рахує комплексну експоненту «в лоб». Замість цього низькорівневі C-бібліотеки запускають тригонометричні алгоритми (як-от CORDIC чи наближення поліномами Тейлора), щоб вирахувати два звичайні дійсні числа:
Обчислити дійсне значення з плаваючою крапкою R .
Обчислити дійсне значення з плаваючою крапкою I.
Зберегти двоелементний масив [R, I] у пам’яті.
Уявна одиниця i — це суто софтверна конвенція й абстракція. Апаратне забезпечення оперує виключно дійсними числами, а софт підтримує «уявну» математику лише за рахунок правильного порядку додавання, множення та віднімання цих дійсних чисел.
Як DFT обчислюється в реальному світі
Пригадаємо, що таке DFT (тут я використовуватиму позначення A для результату перетворення Фур’є, щоб пояснити як 1D (рядки), так і 2Dб - стовпці та рядки):
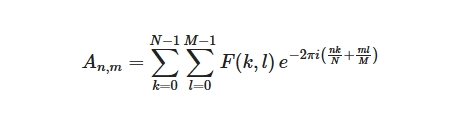
Здавалося б, на практиці для його обчислення достатньо згенерувати 2D-матриці синуса й косинуса, перемножити їх із матрицею зображення та повторити це для кожного рядка й стовпчика, аби знайти підсумкову суму.
Проте такий «наївний» підхід вимагатиме складності в N N = N^2 операцій для 1D-сигналу, а для 2D-зображення ми отримаємо карколомні N * M N M = N^2 M^2 операцій.
Проте завдяки алгоритмам оптимізації, таким як алгоритм Кулі — Тьюкі Radix-2 (який працює за принципом «розділяй і володарюй»), складність падає до набагато приємніших:
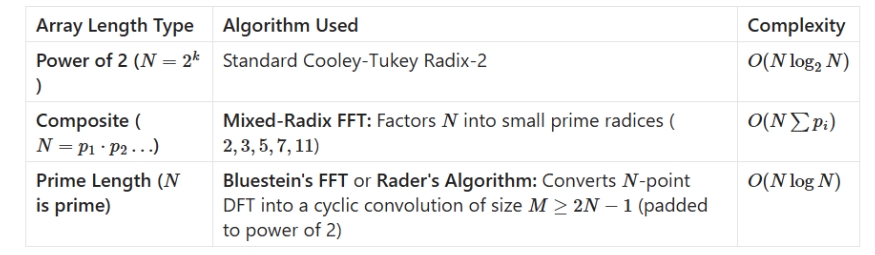
Надалі я докладно поясню як працює алгоритм Кулі - Тьюкі. Це не інше перетворення, а те ж саме дискретне перетворення по Фур’є, але оптимізоване для цифрових обчислень.
Обчислюємо алгоритм Кулі — Тьюкі для 1D-масиву
Коли я вперше розбиралася з цим алгоритмом, у мене була купа запитань і мало що здавалося зрозумілим. Тому я спробую пояснити все «на пальцях» спочатку для 1D-випадку, а потім уже в деталях розібрати 2D.
Алгоритм Кулі — Тьюкі Radix-2 ділить 1D-масив на дві частини: елементи з парними та непарними індексами.
Якщо довжина N = 2^n, повне сумування рекурсивно розбивається на доданки з парними індексами f(2r) та непарними індексами f(2r+1):
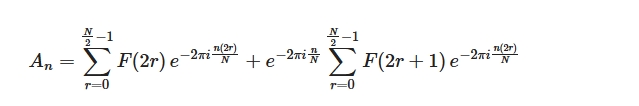
Це й є використання формули Ейлера cosx+ isinx.
Нехай E відповідає за парні індекси, а O — за непарні. Обидві половини обчислюються за допомогою однієї-єдиної операції «метелика» (butterfly operation):
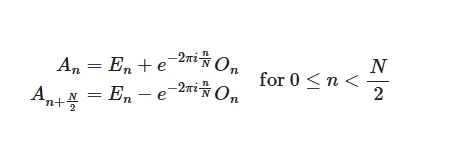
Мені подобається уявляти це як крила метелика: ліве крило відповідає за парні елементи, а праве — за непарні. Завдяки цьому замість двох окремих сумувань ми отримуємо два блоки, які можна використати повторно.
Саме це перевикористання проміжних результатів скорочує складність обчислень із N^2 до N logN.
Як обчислюється 2D FFT
Тепер перейдемо до деталей. Майже у всіх сучасних фреймворках DFT з алгоритмом Кулі- Тьюкі має назву FFT (Fast Fourier Transform — швидке перетворення Фур’є). Це все ще дискретний варіант перетворення Фур’є, але зі суттєвими алгоритмічними оптимізаціями. У бібліотеках на кшталт NumPy обчислення зазвичай розбивається на такі ключові кроки:
Розбиття вхідних даних на парні та непарні елементи (Evens & Odds).
Спрощення експоненціальних виразів із залученням уявної одиниці i.
Застосування Twiddle factor, який завдяки симетрії скорочує кількість операцій удвічі.
Використання ермітової симетрії (Hermitian symmetry) для дзеркального відображення та економії пам'яті.
Усе це — складові алгоритму Кулі — Тьюкі, який слугує фундаментальною базою для FFT у всіх популярних обчислювальних фреймворках. У результаті складність обробки 2D-зображень падає з карколомних
Алгоритм Кулі — Тьюкі та симетрії
Алгоритм Кулі — Тьюкі активно спирається на три ключові типи симетрії: симетрію поворотних множників (twiddle factor symmetry), сепарабельність (роздільність завдяки формулі Ейлера) та ермітову симетрію. Розглянемо коротко кожну з них.
Twiddle factor та симетрія обертання
Поворотний множник (twiddle factor) — це матриця значень за формулою Ейлера для кожного пікселя. За розмірністю вона збігається із зображенням, хоча на практиці замість однієї важкої 2D-матриці обчислюють дві одновимірні (1D) матриці поворотних множників — окремо для рядків та стовпчиків.
У теорії twiddle factor — це скалярне комплексне число, яке задає точку на одиничному колі:
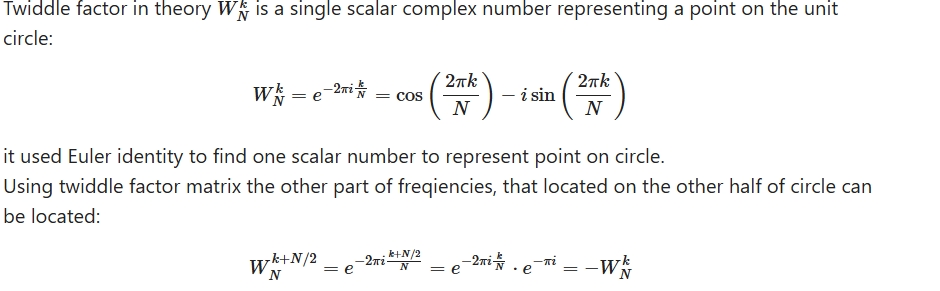
Тобто, негативні значення = позитивним значенням зі знаком -.
// Комплексне множення поворотного множника на непарний елемент
std::complex<float> temp = twiddle_table[k] * O;

// Верхній елемент (додавання)
out[upper_idx] = E + temp;

// Нижній елемент (віднімання автоматично застосовує симетрію обертання через -1)
out[lower_idx] = E - temp;
Оскільки обидва вихідні значення (out[upper_idx] та out[lower_idx]) використовують спільну змінну temp, лише одне комплексне множення дає нам одразу дві точки спектра.
Симетрія обертання ґрунтується на властивостях піднесення i до степеня.
Синусоїдальні та косинусоїдальні хвилі мають кругову (тригонометричну) природу. Якщо зсунутися на пів періоду хвилі 180 градусів, значення функції змінює свій алгебраїчний знак на протилежний: i^2 = -1, i^3 = -i, i^4 = 1.
Тут важливо зауважити: цю симетрію не варто сприймати як рівняння непарності f(-x) = -f(x).
Та виникає слушне запитання: чому б нам просто не використати матрицю? Адже в лінійній алгебрі таке перетворення можна обчислити всього за одну матричну операцію:
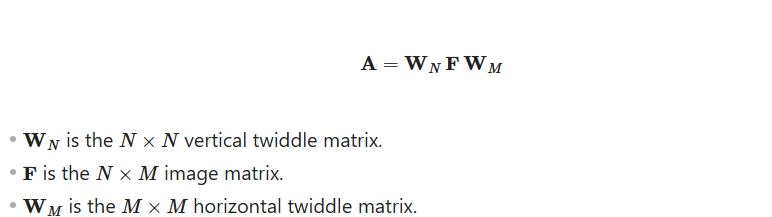
Цілком логічно припустити, що використання оптимізованих рушіїв для матричного множення на кшталт NumPy могло б суттєво прискорити процес. Проте якби обчислення виконувалися «в лоб», фреймворк здійснював би повноцінне 2D-матричне множення без урахування властивостей симетрії. Це вимагало б N^2* M^2 операцій, що є надзвичайно повільним для зображень високої роздільної здатності.
Сепарабельність (властивість роздільності)
Розбиваємо 2D на 1D
Навіщо виконувати тисячі й тисячі зайвих операцій, якщо можна обчислити рядки та стовпчики окремо? У класичному безперервному перетворенні Фур’є це зробити значно складніше через природу неперервних функцій, але в дискретному варіанті (DFT) усе набагато простіше.
Завдяки сепарабельності двовимірна матриця поворотних множників легко розкладається на дві одновимірні (1D) матриці: одна матриця для стовпців, інша для рядків.
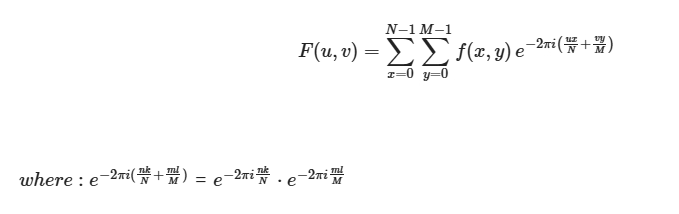
Ермітова (комплексно-спряжена) симетрія
Додатна частина = від’ємна частина
Це одна з найзахопливіших і водночас найскладніших симетрій у всій цій темі.
Операцію спряження ввів Шарль Ерміт, досліджуючи властивості комплексних чисел і матриць, для яких транспонована й комплексно-спряжена матриця дорівнює вихідній (самоспряжена або ермітова матриця).
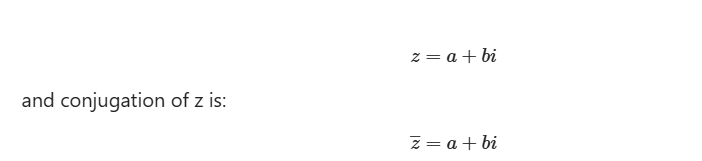
Операцію спряження найпростіше зрозуміти саме як властивість симетрії:
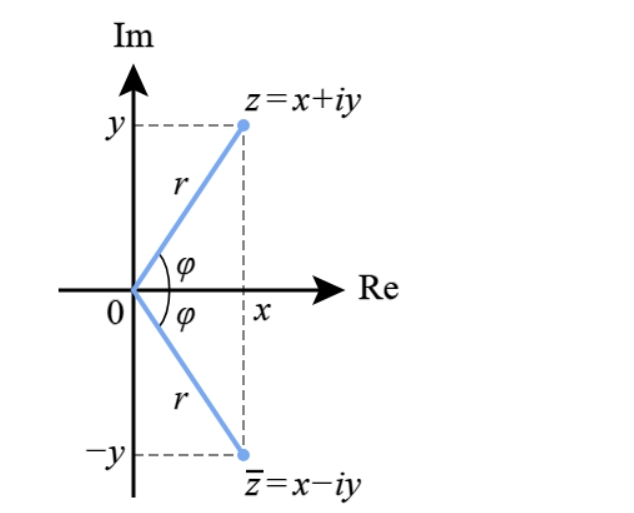
У FFT ці властивості симетрії проявляються в амплітудному та фазовому спектрах:
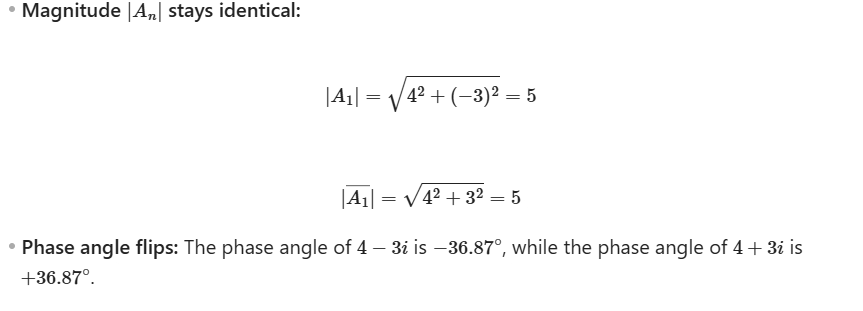
Вкрай важливо не плутати симетрію поворотного множника (twiddle symmetry) з ермітовою симетрією: симетрія поворотного множника дає коефіцієнт, завдяки якому ми обчислюємо парні й непарні індекси без зайвих повторних множень, тоді як ермітова симетрія дозволяє розрахувати лише першу половину спектра, оскільки друга є її дзеркальним відображенням (із протилежним знаком уявного компонента). Це забезпечує 50% скорочення обчислень (50% Compute Reduction): частотні відліки (frequency bins) для n > N/2 повністю пропускаються під час виконання алгоритму, оскільки їхні амплітуди є абсолютно надлишковими.
Приклад обчислення FFT на матриці 4x4
Цей приклад описує обчислення FFT з математичної точки зору так, як це реалізовано у більшості сучасних фреймворків (детальніший суто технічний розбір чекає на вас у наступному розділі).
Окей, ця частина спочатку може здатися дещо заплутаною, і я провела кілька годин, аби придумати, як пояснити її максимально наочно.
Уявіть, що ви вирішили спекти тонкі млинці і маєте чіткий список покупок:
(Крок 1) Що потрібно купити:
Яйця
Борошно
Молоко
Цукор
У більшості супермаркетів яйця знаходяться в холодильному відділі поруч із молоком, а борошно та цукор — у відділі бакалії. Тому найоптимальніший маршрут — спочатку взяти яйця й молоко, а вже потім перейти до борошна та цукру (або навпаки), замість того, щоб хаотично бігати між відділами строго за початковим списком. (Саме так працює перегрупування за парністю / Bit-Reversal Permutation у FFT!)
Тепер, коли у вас є всі необхідні інгредієнти, можна починати готувати.
(Крок 2):змішуємо яйця + молоко
змішуємо цукор + борошно
(Звісно, можна спробувати змішати яйця з борошном, але результат буде так собі).
(Крок 3) з’єднуємо все разом
(Крок 4) смажимо на пательні
Як бачите, кожен крок тут розділений заради оптимізації. І хоча деякі кроки на перший погляд здаються не зовсім логічними, давайте спробуємо «приготувати млинці» вже з комплексних/уявних чисел.
В алгоритмі Кулі — Тьюкі парні та непарні індекси обробляються окремо. Уявімо, що результат алгоритму — це наш візок із покупками, а сам список покупок розбитий на групи парних і непарних елементів. Припустимо, початкова матриця виглядає так:
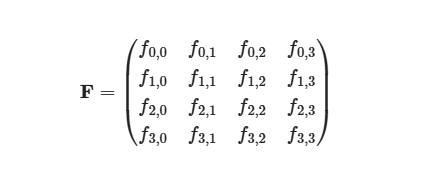
(Крок 1) Розділяємо індекси на парні та непарні.
Найшвидший апаратний спосіб зробити це — бітова інверсія індексів (bit-reversal permutation):
Нехай [p_0, p_1, p_2, p_3] — це перший рядок матриці. Аналогічно до нашої історії з яйцями та молоком у супермаркеті, ми маємо розгрупувати елементи таким чином:
Непарні (Odds): p_1, p_3
Парні (Evens): p_0, p_2
В оперативній пам’яті (RAM) ця операція виконується наступним чином:
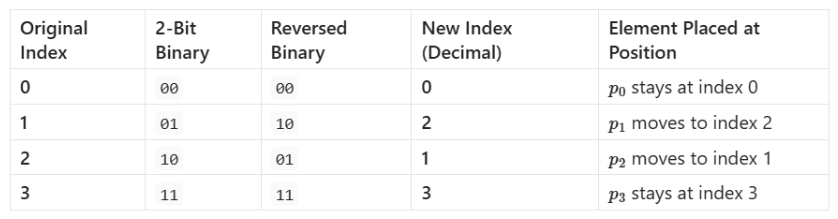
Підсумкове розміщення в пам’яті (memory layout): [p_0, p_2, p_1, p_3]. Тепер ми можемо взяти першу половину як парні елементи, а другу — як непарні.
Ця ж операція послідовно повторюється для всіх рядків матриці:
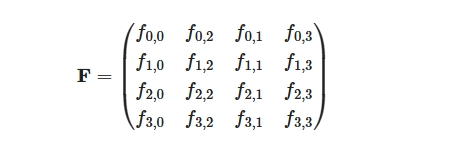
(Крок 2) Обчислюємо малих «метелики» за алгоритмом Кулі — Тьюкі
Одне крило відповідає за парні елементи, інше — за непарні. Тепер нам потрібно визначити та обчислити значення для парних і непарних гілок.
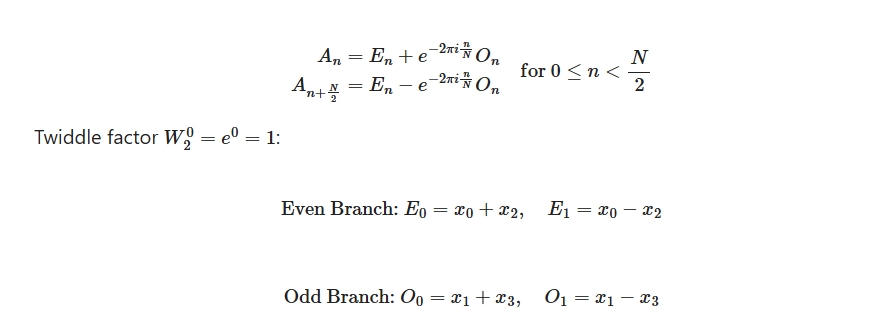
(Крок 3) 4 малі «метелики» для рядків
Маючи парні та непарні крила, ми тепер можемо розрахувати поворотні множники (twiddle factors). Причому обчислити потрібно лише N/2 значень, а для другої половини — просто змінити знак на протилежний.
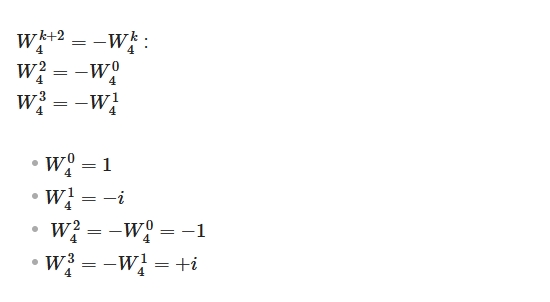
Супер! Давайте обчислимо значення A_0, A_1, A_2, A_3 для першого рядка:
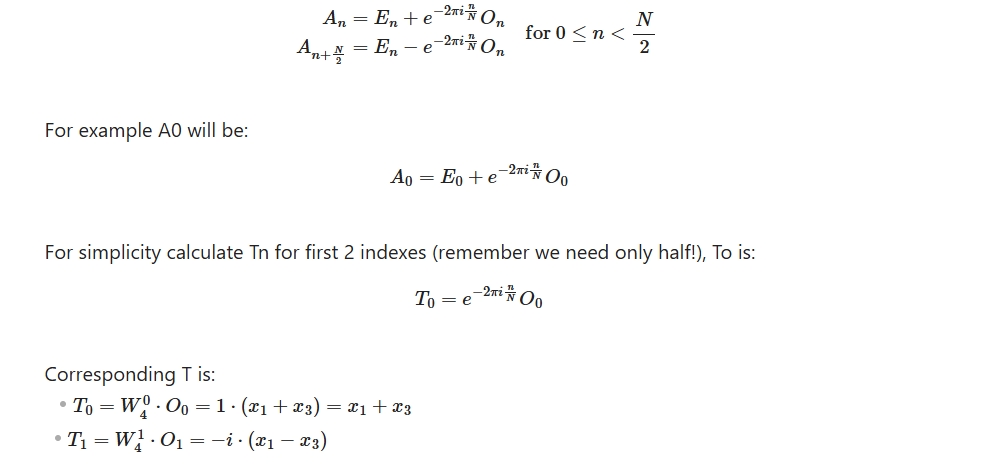
Тепер ми нарешті бачимо підсумковий результат для першого рядка — об’єднання обчислених гілок із поворотними множниками:
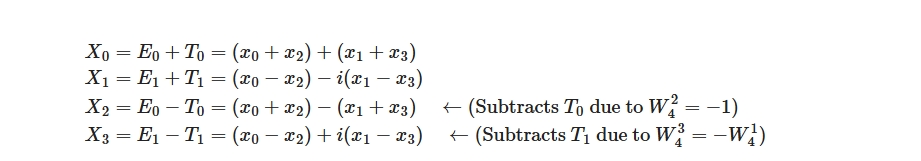
Ось де ховається справжня магія: нам потрібні лише дві пари обчислень, щоб отримати всі 4 значення!
Зверніть увагу, що X_0 та X_2 — це дійсні числа, а X_1 та X_3 — комплексні, причому різниця між ними полягає лише в знаці уявного компонента! Це і є фундаментальна властивість ермітової (комплексно-спряженої) симетрії:
По суті, нам навіть не потрібно окремо обчислювати X_3 — ми отримуємо його через зміну знаку.
(Крок 4) Повторюємо весь процес для стовпчиків
Наразі ми виконали множення початкової матриці на 1D-матрицю поворотних множників із сумуванням за всіма елементами рядків:
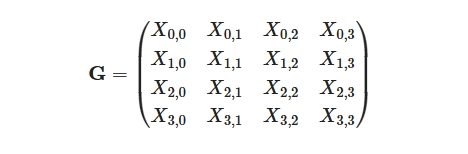
(Крок 4) Повторюємо весь процес для стовпчиків
Наразі ми виконали множення початкової матриці на 1D-матрицю поворотних множників із сумуванням за всіма елементами рядків:
Завдяки властивостям експоненти (і сепарабельності) ми розділили 2D-поворотні множники на окремі одновимірні матриці для рядків та стовпчиків задля суттєвого прискорення. Наступний етап — це повторення всіх попередніх кроків уже для стовпчиків, де ключовим початковим маневром є транспонування.
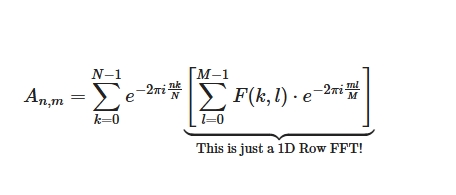
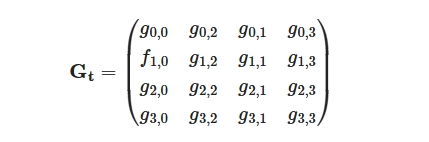
Фаза 1: Транспонуємо G та застосовуємо бітову інверсію
Застосувавши той самий метод бітової інверсії індексів (bit-reversal permutation), отримуємо таку матрицю:
Фаза 2: Обчислюємо матрицю поворотних множників для стовпчиків (які тепер є рядками)
Створюємо аналогічну 1D-матрицю поворотних множників для обробки транспонованих компонентів.
Фаза 3: Обчислюємо малих «метелики»
Цей крок повністю аналогічний обчисленню малих «метеликів» під час обробки рядків (1D DFT).Для першого рядка (який до транспонування був першим стовпчиком) парні та непарні гілки виглядають так:
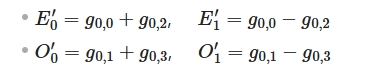
Фаза 4: Множення результатів «метеликів» на матрицю поворотних множників
Обчислюємо T_n:
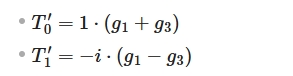
Зверніть увагу: T_1 описує несиметричну хвильову форму (гармоніку без симетрії відносно осі).
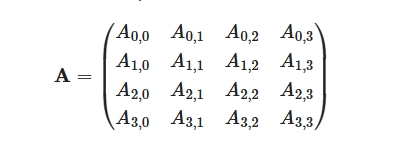
Повторивши ці обчислення для решти рядків і виконавши повторне транспонування (аби повернути матрицю до її початкової орієнтації), ми отримуємо підсумкову 2D FFT матрицю розміром 4x4:
Сподіваюся, це пояснення допомогло вам зрозуміти базову механіку дискретного перетворення Фур’є (DFT). Тепер перейдемо до низькорівневих деталей та того, як усе це реалізовано у сучасних фреймворках.
Як обчислюється DFT у сучасних фреймворках
У таких бібліотеках, як NumPy, SciPy та аналогічних обчислювальних фреймворках, розрахунок DFT підпорядковується описаній схемі, але має кілька додаткових апаратних оптимізацій. На рівні середовища виконання C++ або CUDA не можуть зберігати абстрактні символи уявних чисел на кшталт i безпосередньо в регістрах процесора. Тому масиви комплексних чисел зберігаються в пам’яті як послідовні (суміжні) пари чисел із плаваючою крапкою (interleaved real/imaginary values):
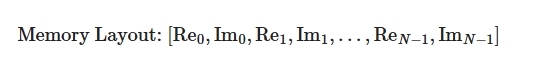
Через це, а також тому, що динамічне виділення пам’яті безпосередньо під час виконання пайплайну обчислень значно повільніше, ніж заздалегідь визначена пам’ять, найпершим кроком є зарезервувати буфери для всіх потрібних у процесі матриць.
(Крок 0) Початкове виділення буферів (виконується один раз заздалегідь!)
Перш ніж починати будь-які перетворення Фур’є, рушій аналізує розмірність вхідних даних (N, M) і за один раз виділяє буфери пам’яті для робочої матриці та двох 1D-матриць поворотних множників (для рядків і стовпчиків).
У сучасних фреймворках FFT ділять на два основні типи — стандартне (комплексне) та для дійсних чисел (Real-valued FFT / RFFT). Єдина принципова відмінність між ними, окрім типів вхідних даних, полягає у ступені використання ермітової симетрії. RFFT розкриває її потенціал на повну, завдяки чому підсумкова матриця виходить суттєво меншою за розміром, ніж у звичайному FFT. Детальніше про RFFT ми поговоримо в наступному розділі.
Виділення пам'яті для матриці:
Для стандартного комплексного FFT (
fft2): Виділяє в неперервній (суміжній) пам’яті вихідну комплексну матрицю розмірністю N* M (із використанням 64-бітних або 128-бітних комплексних типівcomplex64/complex128).Для дійснозначного FFT (
rfft2): Використовує ермітову (комплексно-спряжену) симетрію для створення зменшеного вихідного буфера розмірністю N* M/2+ 1), що знижує витрати пам’яті на 50%.Тимчасова робоча пам'ять (Scratchpad Memory): Виділяє компактний тимчасовий масив або повторно використовує рядки кешу L1 (L1 cache lines) для швидкого збереження проміжних результатів обчислення «метеликів» у 1D-алгоритмі Кулі — Тьюкі.
Виділення пам’яті для матриць поворотних множників:
1D-матриця поворотних множників для рядків (
twiddle_row):Зарезервований вектор розмірністю M/2, у якому заздалегідь обчислюються й кешуються значення матриці W для горизонтального проходу по рядках.
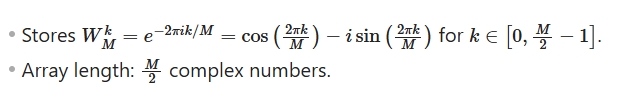
1D-матриця поворотних множників для стовпчиків (
twiddle_col):Зарезервований вектор розмірністю N/2, призначений для повторного використання значений W під час вертикального проходу по стовпчиках (після транспонування).
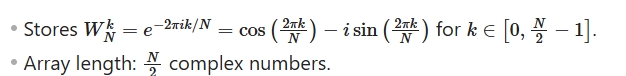
Крок 1: 1D DFT для рядків
Усі наступні кроки повторюють алгоритм із нашого прикладу 4x4, тому зараз ми зосередимося безпосередньо на роботі з оперативною пам’ятью (RAM) та процесором (CPU/GPU).
За C-послідовного розташування в пам’яті (C-contiguous layout / row-major order) елементи одного й того ж рядка знаходяться пліч-о-пліч у фізичних байтах RAM:
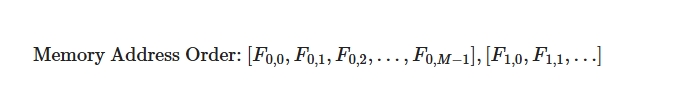
Що робить CPU/GPU: Обчислювальний рушій проходить циклом по кожному рядку й виконує стандартне 1D-перетворення Фур’є за алгоритмом Кулі — Тьюкі розміром M:
Бітова інверсія індексів (bit-reversal permutation) для впорядкування пар парних і непарних елементів.
Обчислення малих «метеликів» — визначення парних (E) та непарних (O) гілок.
Розрахунок T_n за аналогічною схемою, де перший елемент T_0 має вигляд:
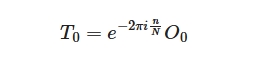
Обчислюємо всі елементи рядків (парні та непарні елементи):
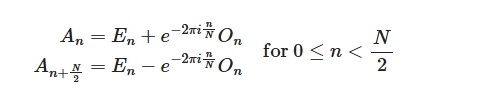
Апаратне прискорення (Hardware Speedup): Оскільки суміжні елементи рядка розташовані послідовно у фізичній оперативній пам’яті, механізми попередньої вибірки (L1/L2 cache prefetchers) миттєво завантажують цілі рядки у кеш-лінії (cache lines). Це дозволяє векторним інструкціям (SIMD / AVX-512) та варп-потокам GPU (GPU warp threads) обчислювати «метелики» для рядків на максимальній швидкості.
Результат після Кроку 1: Проміжна комплексна матриця G розмірністю (N, M).
Крок 2: Транспонування матриці G
Згадаймо, найпростіший спосіб виконати зовнішнє сумування — це транспонувати матрицю G і повторити всі попередні кроки для стовпчиків, які після транспонування стають звичайними рядками.
Чому обчислювальний рушій не може просто пройтися 1D FFT напряму вертикально по стовпчиках?
Якщо звертатися до елементів стовпчика G_{0,0}, G_{1,0}, G_{2,0} напряму, на кожному кроці процесор мусить «стрибати» у фізичній оперативній пам'яті на M елементів уперед. Це спричиняє критичну кількість промахів кешу (cache misses та cache thrashing), змушуючи CPU постійно простоювати в очікуванні повільних даних із RAM. Це нагадує неоптимізований подвійний цикл for по масивній матриці — надзвичайно повільно й сумно.
Транспонування в RAM виконується за такими кроками:
Блокове транспонування (Blocked Matrix Transposition): Фреймворк виконує транспонування безпосередньо в оперативній пам’яті.
Тайлінг у кеш L1 (Cache Tiling): Матриця розбивається на маленькі плитки (тайли) розміром 8 * 8 або 16 * 16, які повністю поміщаються всередині регістрів кешу L1, де рядки та стовпчики міняються місцями з максимальною швидкістю.
Розмірність після Кроку 2: M, N. Дані колишніх стовпчиків тепер розташовані горизонтально й послідовно у неперервній пам’яті.
Крок 3: 1D DFT прохід для стовпчиків (виконується горизонтально на транспонованій матриці G)
Тепер, коли колишні вертикальні стовпчики розташовані горизонтально у фізичній оперативній пам’яті (RAM), обчислювальний рушій виконує звичайний рядковий 1D DFT по всіх нових рядках.
Крок 4: Фінальне зворотне транспонування
Усі рядки та стовпчики вже прожили свій зоряний час у просторі Фур’є — настав час повернути підсумкову матрицю до початкового вигляду. Обчислювальний рушій виконує фінальне транспонування матриці назад до її вихідної орієнтації: з (M, N) до (N, M).
Покроковий пайплайн в пам’яті
[ Вхідна матриця (N, M) у RAM ]
                 │
                 ▼
 (Крок 0) Виділення буферів
          ├── Робоча комплексна матриця (N, M)
          └── 1D Twiddle-вектори: twiddle_row (M/2) та twiddle_col (N/2)
                 │
                 ▼
 (Крок 1) 1D FFT вздовж рядків
          ├── Послідовне читання з RAM (C-contiguous)
          ├── L1/L2 Cache Prefetch + Векторизація (SIMD / AVX-512 / CUDA Warps)
          └── Результат: Проміжна матриця G (N, M)
                 │
                 ▼
 (Крок 2) Блокове транспонування (Cache Tiling)
          ├── Розбиття на плитки 8x8 / 16x16 у кеші L1
          └── Результат: Транспонована матриця Gᵀ (M, N)
                 │
                 ▼
 (Крок 3) 1D FFT вздовж нових рядків (колишніх стовпчиків)
          ├── Повторне послідовне читання рядків із RAM
          └── Результат: 2D-спектр у транспонованому вигляді
                 │
                 ▼
 (Крок 4) Фінальне зворотне транспонування
          └── Повернення орієнтації: з (M, N) назад у (N, M)
                 │
                 ▼
  [ Готова 2D FFT матриця (N, M) ]
Різниця між DFT та RFFT
У попередньому розділі ви побачили, наскільки елегантно можна використати 3 типи симетрії. Стандартне DFT — це надзвичайно потужний інструмент, але воно зберігає повний розмір матриці, і всі обчислення виконуються над масивом вихідного розміру. RFFT (Real-valued FFT) — це аналог DFT, який працює виключно з дійсними вхідними даними (наприклад, звичайними зображеннями чи аудіосигналами) і розкриває потенціал ермітової симетрії на всі 100%. Розглянемо це на прикладі матриці 4x4 для максимальної наочності.
(Крок 0) Виділення пам’яті для всіх необхідних матриць
1. Вихідний буфер пам'яті (Output Memory Buffer):
Наприклад, для вхідної дійсної матриці 4 * 4 вихідний комплекснозначний буфер у RFFT має такі параметри:
Розмірність: 4, 3 комплексних чисел (4 рядки, 4/2 + 1 = 3 стовпчики).
Загальний об'єм: 12 комплексних чисел (що еквівалентно 24 дійсним числам із плаваючою крапкою
float32/float64).
2. 1D-матриці поворотних множників (Twiddle factor matrices):
Матриця поворотних множників для рядків (
twiddle_row): вектор розміром у 2 комплексні числа (W_4,0 та W_4,1) для горизонтального перетворення довжиною 4.Матриця поворотних множників для стовпчиків (
twiddle_col): вектор розміром у 2 комплексні числа (W_4,0 та W_4,1) для вертикального перетворення довжиною 4.
(Крок 1) 1D RFFT вздовж рядків
Для кожного рядка виконується те саме класичне 1D DFT, що й у попередніх прикладах.
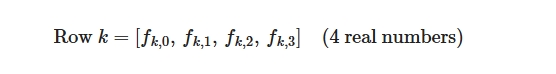
Відкидання надлишкових даних за ермітовою симетрією (Hermitian Dropping): Оскільки вхідні пікселі є суто дійсними числами, одновимірний вихід [X_0, X_1, X_2, X_3] володіє комплексно-спряженою симетрією (X_3 = X_1 спр.). Тому нам достатньо обчислити й зберегти лише перші 3 елементи ([X_0, X_1, X_2]), а 4-й стовпчик (X_3) відкидається як дубльована інформація:
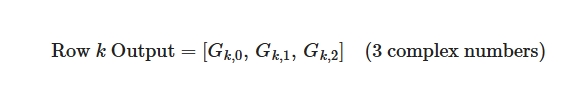
Матриця G отримала розмірність 4 * 3, а не 4 * 4, як це було у попередньому прикладі зі стандартним FFT.
(Крок 2) Транспонування матриці G (з 4x3 у 3x4)
Виконується транспонування матриці $G$ в оперативній пам’яті:
Розмірність змінюється з 4, 3 на 3, 4.
Матриця G тепер складається з 3 неперервних (суміжних) рядків, де кожен рядок є колишнім стовпчиком довжиною 4 з попереднього кроку.
(Крок 3) Прохід 1D FFT по колишніх стовпчиках
Критично важлива відмінність: Елементи у транспонованій матриці G вже є комплексними числами!
(Саме тому під час повторного проходу вздовж другої осі виконується звичайне комплексне 1D FFT, а не RFFT, адже проміжні дані після обробки першого виміру втратили свою суто дійсну природу).
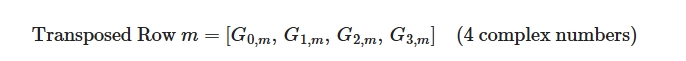
Через це ермітова симетрія більше не застосовується вздовж цієї осі:
Виконання: рушій запускає стандартне комплексне 1D FFT (
fft) довжиною 4 для кожного з 3 рядків, використовуючи заздалегідь виділений масив поворотних множниківtwiddle_col.Вихідний розмір: Зберігаються всі 4 вертикальні частотні компоненти [A_{0,m}, A_{1,m}, A_{2,m}, A_{3,m}].
Після обробки всіх 3 транспонованих рядків розмірність матриці становить (3, 4) комплексних чисел.
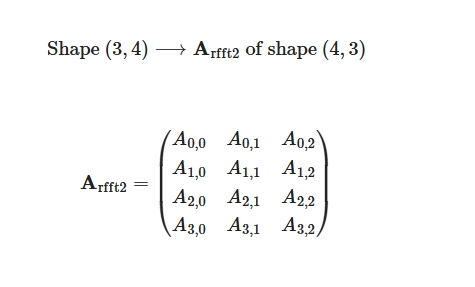
Ось за що я люблю математику: трохи магії тут, трохи там — і отримуємо елегантний та оптимізований спосіб обчислення для згорткових шарів CNN без потреби занурюватися у низькорівневий C.
Список фреймворків FFT
Обчислювальні рушії
NumPy (
np.fft): Використовує C99/C++ бібліотеку PocketFFT (похідну від FFTPACK). Вона підтримує розкладання зі змішаною основою (mixed-radix decomposition), довільні розмірності, SIMD-векторизацію та потокобезпечність (thread safety).SciPy (
scipy.fft): Побудований поверх PocketFFT та обгорток над FFTW (Fastest Fourier Transform in the West). Містить алгоритми автоналаштування планувальника (auto-tuning planner), які аналізують розміри кешу конкретного процесора.PyTorch (
torch.fft) / TensorFlow: На CPU делегують обчислення до PocketFFT або Intel MKL, а на GPU — до NVIDIA cuFFT (яка максимально використовує архітектуру розділюваної пам’яті / shared memory та варп-інструкції SIMD shuffle).
Багатовимірні перетворення Фур'є (fft2, fftn)
Оскільки базисні функції 2D DFT є сепарабельними, фреймворки обчислюють 2D/N-D FFT як послідовність одновимірних проходів:
1D FFT для кожного рядка x уздовж стовпчиків y.
Транспонування матриці або коригування кроків пам’яті (strides), щоб вирівняти дані стовпчиків у неперервний блок, який ідеально лягає в кеш-лінії L1/L2.
1D FFT вздовж кожного стовпчика y.
Оптимізації для дійсних чисел (rfft / irfft)
Коли вхідні дані є суто дійсними , частотний спектр володіє ермітовою симетрією. Фреймворки ефективно використовують цю властивість:
Пакування дійсної послідовності довжиною N у комплексний масив довжиною N/2.
Обчислення одного комплексного FFT довжиною N/2.
Розпакування результату через фінальний прохід «метелика», що скорочує вдвічі як час виконання, так і споживання пам'яті (повертається N/2 + 1 комплексних значень).
Найкращі книги з аналізу Фур’є
Аналіз Фур’є — це дійсно складна тема, і я безмежно вдячна цим книжкам за те, що вони допомогли мені розібратися: