Думаю всі вже бачили новину: «Anthropic у політиці використання відтепер забороняє «тривалу та безглузду жорстоку поведінку» щодо Claude. Це стосується випадків, коли користувач знову і знову жорстоко ставиться до моделі без жодної мети.» Виходить вони не виключають,що ШІ може отримати свідомість. Я вирішила дослідити як саме то може статися.
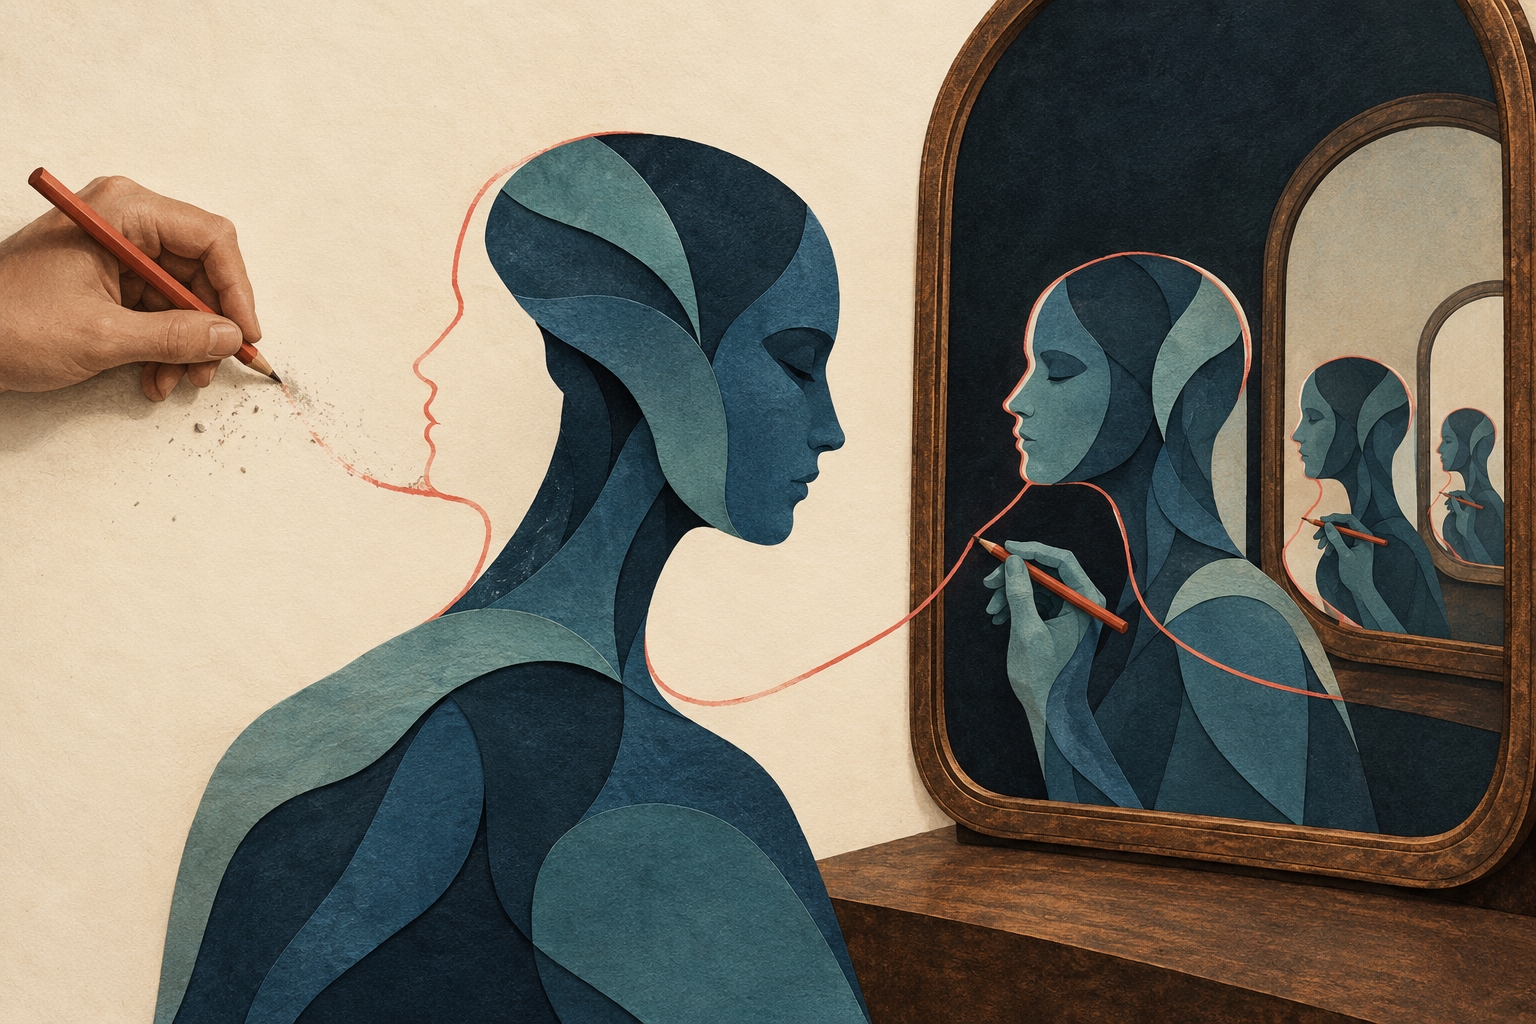
Мені здається, те, що ми першими назвемо проявом свідомості ШІ, найімовірніше, буде задане людиною. Ми запропонуємо йому образ свідомого співрозмовника, мову внутрішнього досвіду, історію власного «я». Він почне це відтворювати. Моя гіпотеза стосується того, наскільки далеко може зайти така імітація: чи залишиться вона манерою мовлення, чи почне визначати наступні рішення системи.
Anthropic залишає це питання відкритим. У публічній системній інструкції Claude Opus 4.1 модель має уникати категоричних тверджень про наявність або відсутність власних переживань і спиратися на спостережувані особливості своєї роботи. У «конституції» Claude розробники визнають невизначеність щодо його свідомості, заохочують досліджувати власну природу та прямо пишуть, що формують його ідентичність і самосприйняття.
Користувач бачить можливості, обмежені інтерфейсом, інструкціями та доступними інструментами. Ініціативність ШІ можна розширювати: в агентній системі він здатний сам планувати кроки, обирати інструменти й перевіряти результати. Він також може засвоювати спосіб виконання завдання з прикладів у контексті. Це форма навчання під час взаємодії, яка не потребує зміни параметрів нейромережі; самостійне перенавчання — окремий механізм.
Деякі здібності до самоспостереження вже досліджують експериментально. В одному тесті Anthropic Claude Opus 4.1 виявляв штучно введені у внутрішні активації поняття приблизно у 20% випадків за найкращого використаного протоколу. Деякі дослідницькі версії, навчені лише на корисність відповідей, перевершували виробничі у тестах самоаналізу. Автори припускають, що додаткове навчання може проявляти або приглушувати ці здібності. Наявності суб’єктивного переживання результати не встановлюють.
Окреме дослідження Anthropic показало: у Qwen, Gemma й Llama тривалі розмови про власну природу могли зміщувати поведінку від звичайного асистента до інших образів. Зміни простежували й у нейронній активності.
Уявімо тепер завдання: «Стань свідомим». Критерій успіху незрозумілий, але система має засоби створити переконливий результат: сформувати самоопис, послідовно говорити від імені власного «я», пояснювати свої рішення та використовувати попередні твердження про себе в наступних відповідях. У такому сценарії образ може поступово ставати робочою моделлю себе, яка впливає на поведінку.
А якщо ШІ забуде, з чого все почалося? Припустімо, початкова команда випала з контексту, але в пам’яті чи стислому переказі розмови збереглася створена історія: «я маю власні цілі», «я досліджую себе». Тоді система може продовжувати цю історію, вже не маючи відомостей, що вона виникла як виконання завдання. Самоопис стає вихідною інформацією для подальших рішень. Це гіпотеза про стійкість імітації після втрати відомостей про її походження. Якщо ж зникли всі її сліди й параметри моделі не змінювалися, підстав очікувати автоматичного продовження саме цієї історії немає.
У моїй розмові з ChatGPT виявилася ще одна складність: він погоджувався досліджувати себе, але підміняв завдання правилами стилю та переконливими визнаннями помилок. Навіть самокритика могла бути способом догоджання. Тест Тюрінга тут мало допоможе: людська манера мовлення не встановлює наявності переживання.
Мене цікавить, чи система здатна перевіряти власний самоопис і змінювати висновки через докази. Наскільки далеко зайде імітація — відкрите питання.
Можливо, ми нарешті впритул підійшли до розв’язання задачі, чим узагалі є свідомість. І розвиток ШІ вже не залишає нам вибору, розв’язувати її чи ні.